当ブログにはPRを含みます。
第5章「テキスト生成AIのプロンプト制作と実例」は、生成AIパスポート試験で最も実務に近く、最も取りこぼしやすい章です。
取りこぼしやすい理由は2つあります。1つは、前半のLM・LLM・Temperature・Top-pが急に技術寄りになること。もう1つは、後半の「使い方の名前」が20種類近くあり、どれも似ているため、場面を読んで名前を選ぶ問題で迷うことです。
ただし、この章にもはっきりした解き方の軸があります。プロンプトの4要素(指示・文脈・入力・出力形式)のうち、どれの話をしているかを特定することです。この記事では、その軸を使って第5章の範囲を整理していきます。
この記事でわかること
- LM・ニューラル言語モデル・LLMの関係と、「大規模」と呼ばれる理由
- TemperatureとTop-pの違いを、値を動かしたときの変化で理解する方法
- プロンプトの4要素(Instruction・Context・Input Data・Output Indicator)の見分け方
- Zero-ShotとFew-Shotの違いと、Few-Shotが効く場面
- 実践・ビジネス応用で問われる使い方を、カテゴリ別に整理した一覧
- テキスト生成AIが苦手な4つと、それぞれの「理由」
- 第5章の形式に合わせた例題3問と解説
この記事は、生成AIパスポート試験の全範囲を章別にまとめたシリーズの第5章(最終章)です。
▶ 生成AIパスポート 第4章「情報リテラシーとAI社会原則」の要点|個人情報保護法・著作権・AI新法
第5章で問われるのは「プロンプトのどこが足りないか」
第5章は5つの中項目に分かれます。前半2つが用語、後半3つが使い方です。
中項目ごとの出題のされ方
| 中項目 | 主な用語 | 問われ方 |
|---|---|---|
| LMとLLM | LM、n-gramモデル、ニューラル言語モデル、LLM、プレトレーニング、ハイパーパラメータ、Temperature、Top-p、プロンプト、プロンプトエンジニアリング | 用語の定義/値を変えたときの変化 |
| プロンプティングの基礎 | Instruction、Context、Input Data、Output Indicator、Zero-Shot、Few-Shot | プロンプト中のどこがどの要素か/書き方の名前 |
| LLMプロンプティングの実践 | 校正、整理、要約、箇条書き変換、対象変更、話者設定、会話変換、例え話、数字の変換 | 場面から使い方の名前を選ぶ/適したプロンプトを選ぶ |
| ビジネス応用 | メール、アンケート、キャッチコピー、テンプレート、アジェンダ、手順分解、タスク抽出、翻訳、ディベート、姓名分離、ふりがな、ブレスト、質問させながら進める | 場面から使い方の名前を選ぶ |
| 不得意なこと | 文字数指定、計算、最新の情報、芸術の批評 | 苦手なことと、その理由を選ぶ |
第5章を解く軸は「4要素のどれか」と「なぜできないか」
軸1:プロンプトの4要素のどれの話か。 「〜してください」という作業の指示はInstruction、立場や読み手の説明はContext、処理される素材そのものはInput Data、出力の形や字数の指定はOutput Indicatorです。後半の「適したプロンプトを選びなさい」という問題も、4要素が揃っている選択肢を選べば当たります。
軸2:苦手なことは「理由」とセットで問われる。 この章の最後の中項目は、単に「苦手なことは何か」ではなく「なぜ苦手なのか」を問う形が多く出ます。理由まで言えるようにしておく必要があります。
LMからLLMへ:言語モデルの発展
言語モデルとは「次に来る言葉の確率を出すもの」
LM(Language Model、言語モデル)は、ある言葉の並びに続いて、次にどの言葉が来やすいかを確率で表すモデルをまとめて指す言葉です。
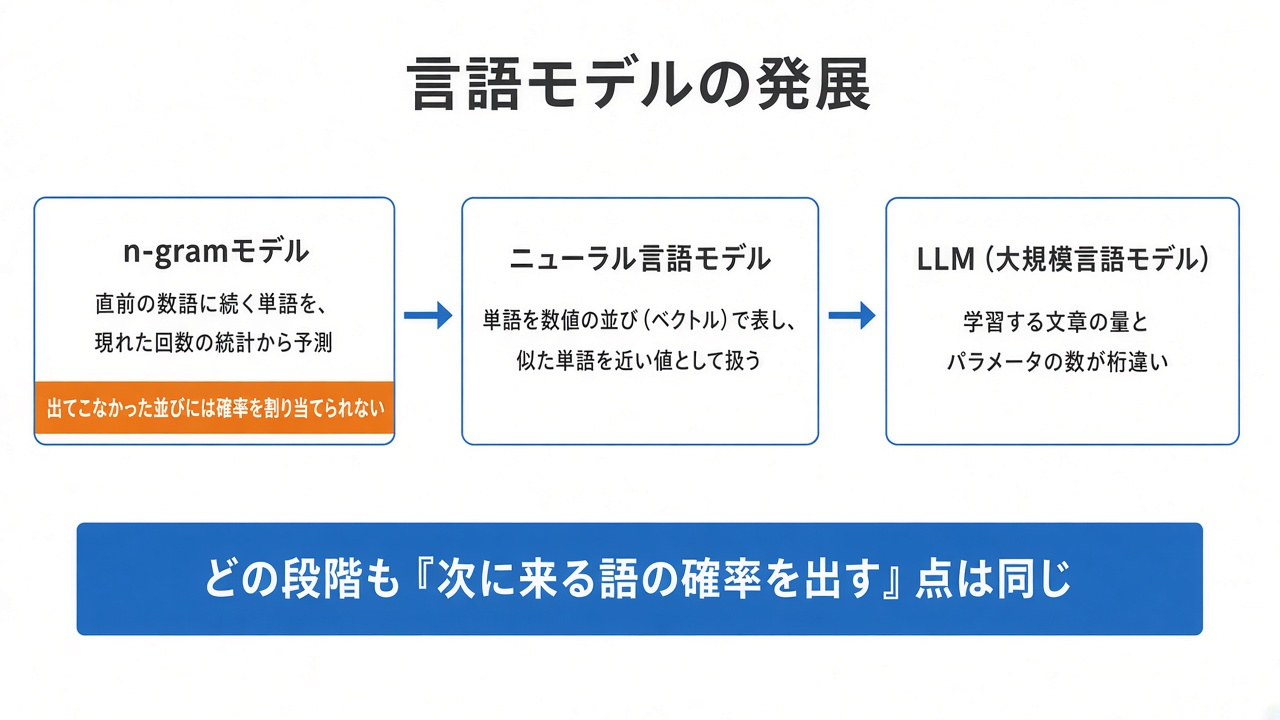
図:n-gramモデル(数え上げ)から、ニューラル言語モデル(単語をベクトルで表す)を経て、LLM(大量の文章と桁違いのパラメータ)へ。どの段階でも「次に来る語の確率を出す」という本質は変わりません。変わったのは、確率の求め方と規模です。
n-gramモデルは、言語モデルの初期の手法です。直前に並ぶ決まった数の単語(例えば2語や3語)の並びをもとに、次に来る単語の出現しやすさを、文章中に現れた回数の統計から求めます。数え上げなので、学習用の文章に出てこなかった並びには確率を割り当てられない、という弱点がありました。
ニューラル言語モデルは、ニューラルネットワークを使って次に来る語の出やすさを求める言語モデルです。単語を数値の並び(ベクトル)で表し、使われ方の似た単語を近い値として扱うことで、学習用の文章に出てこなかった単語の並びにも確率を割り当てやすくしました。これがn-gramモデルからの最大の改善点です。
LLM(Large Language Model、大規模言語モデル)は、大量の文章で学習し、非常に多くのパラメータを持つことで、要約や翻訳など幅広い作業を1つのモデルでこなせるようになった言語モデルです。
「大規模」と呼ばれる理由として問われるのは、「学習に使う文章の量と、モデルが持つパラメータの数が桁違いに多いから」です。構造が特別なのではなく、量が桁違いだから、というのが答えです。
プレトレーニングとハイパーパラメータ
プレトレーニング(事前学習)は、LLMを作る工程のうち、大量のテキストデータを使ってモデルの重みを最初に学習させる段階です。大量の文章で次の単語を予測する学習を繰り返し、言葉の使われ方の土台を作ります。
この後に、第2章で扱ったファインチューニングやRLHFによる調整が続く、という流れです。先に土台を作るのがプレトレーニング、後から用途に寄せるのがファインチューニング、という順序で覚えてください。
ハイパーパラメータは、モデルを学習させる前に人が設定する値で、学習率のように学習の進み方を左右します。学習の回数など、学習や出力のしかたを決めるために人が設定する値、という言い方もします。
第1章で扱った重み(パラメータ)との違いが問われます。パラメータは学習で値が決まる、ハイパーパラメータは人が決める。 この対比で切れます。
TemperatureとTop-p:似ているが、調整の仕方が違う
生成AIのAPIで出力のばらつきを調整するパラメータが2つあります。試験では、それぞれの説明と、値を変えたときの変化が問われます。
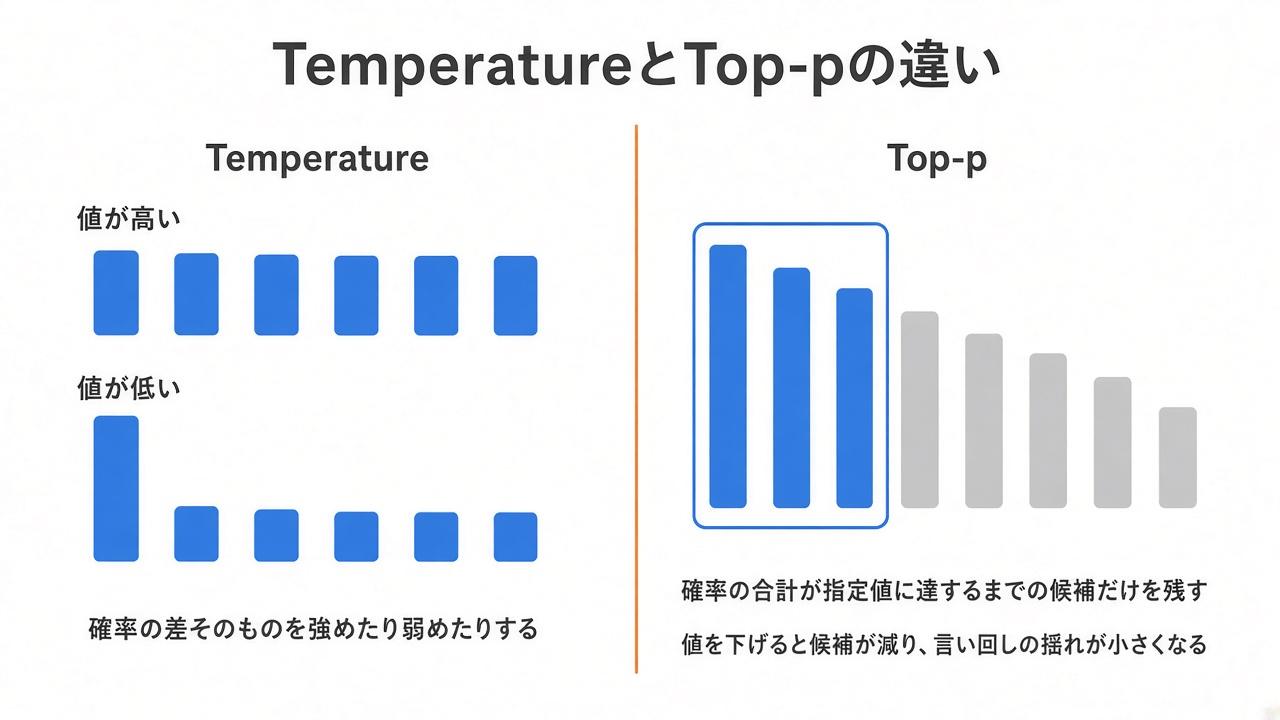
図:Temperatureは、次に来る語の確率の差そのものを強めたり弱めたりします。Top-pは、確率の高い順に候補を足し合わせていき、合計が指定した値に達するまでの候補だけを選択肢に残します。どちらも出力のばらつきを調整しますが、効かせ方が違います。
Temperatureは、次のトークンの確率分布の偏りを強めたり弱めたりして、出力のランダムさの度合いを調整するパラメータです。値を下げると確率の高い語に寄りやすくなり、上げると言い回しの揺れが大きくなります。
Top-pは、次のトークンの候補を確率の高い順に並べて足し合わせ、その合計が指定した値に達するまでの候補の中から選ぶようにするパラメータです。
値を動かしたときの変化も出題されます。Top-pの値を1から0.1に下げると、「出やすさの高い一部の候補からだけ選ばれ、言い回しの揺れが小さくなる」という変化が起きます。
筆者は、中古のゲーミングノートPCでローカルLLMを動かしてみたことがあります。手元で動かすと、Temperature や Top-p のつまみが設定画面にそのまま並んでいて、値を変えながら同じ質問を何度も投げられます。クラウドのサービスを使っているとこれらは裏に隠れているので、言葉として覚えるしかありません。自分で動かしてみると、Temperature を上げたときの「言い回しが散る」感じが体感として残ります。試験の範囲としては定義が言えれば十分ですが、腹落ちさせたい方には手を動かしてみるのをおすすめします。
▶ 中古ゲーミングPCでローカルLLMはどこまで使える?つまずいた6つのポイントと正直な感想
プロンプトとプロンプトエンジニアリング
プロンプトは、テキスト生成AIに対して利用者が入力する、指示や質問などの文そのものを指します。
プロンプトエンジニアリングは、目的に合った出力が得られるように、生成AIへの指示文の書き方を工夫し、試しながら改善していく取り組みです。一発で書くものではなく、改善していくもの、という点が定義に入っています。
有効な工夫として問われるのは次の2つです。
- 期待する出力の例を示し、同じ形で答えさせる
- やってほしくないことではなく、やってほしいことを具体的に書く(否定形で並べない)
「禁止事項を並べる」より「望む形を示す」ほうが有効、というのが基本の形です。
プロンプトの4要素を見分ける
ここが第5章の中心です。プロンプトは4つの要素に分解でき、それぞれの名前が問われます。
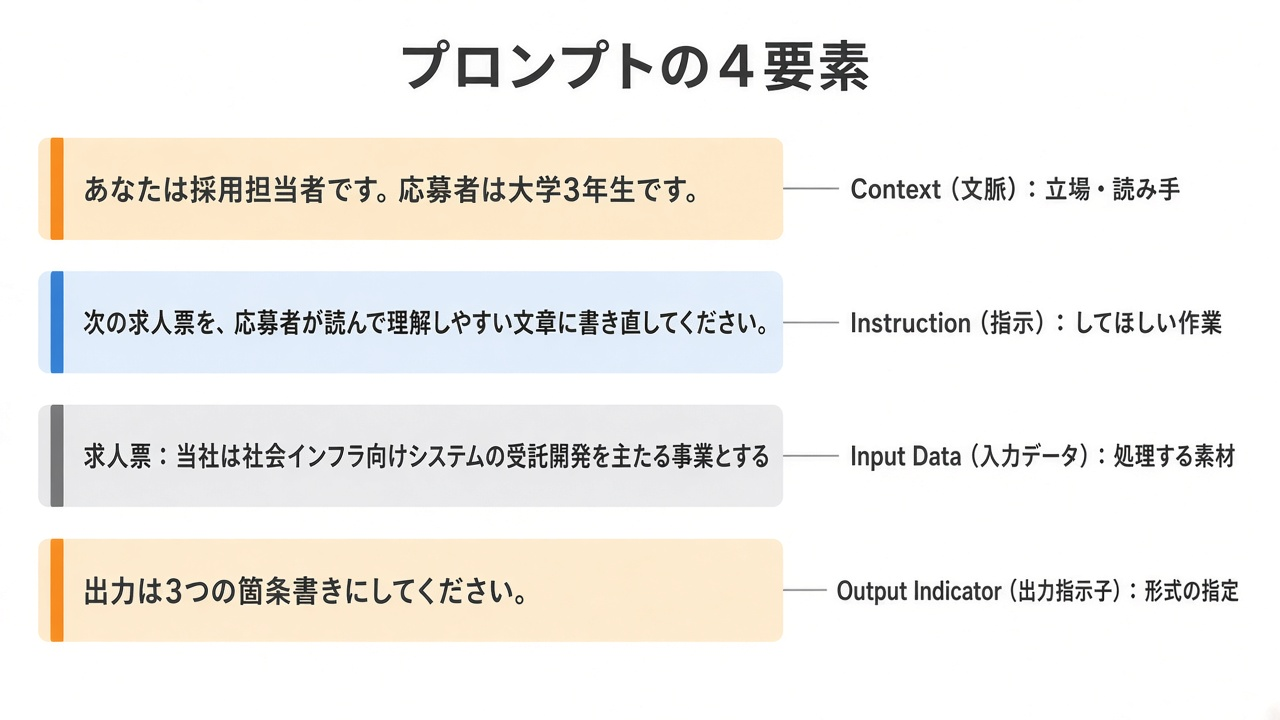
図:1つのプロンプトを4要素に色分けしたもの。立場や読み手の説明がContext、やってほしい作業がInstruction、処理の対象となる素材がInput Data、出力の形や字数の指定がOutput Indicatorです。この分解ができれば、「【 】の部分にあたる要素は?」という出題は確実に取れます。
| 要素 | 役割 | 例 |
|---|---|---|
| Instruction(指示) | モデルに実行してほしい作業内容そのもの | 「次の社内規程を、入社1年目の社員に向けてやさしく言い換えてください」 |
| Context(文脈) | 答えるうえでの前提となる状況。立場・読み手など | 「あなたは研修担当で、読み手は新入社員です」 |
| Input Data(入力データ) | 処理の対象となる素材そのもの | 「規程:『時間外労働は、事前に所属長の承認を得た場合に限り認める』」 |
| Output Indicator(出力指示子) | 出力の形式や種類の指定 | 「結果は、商品名・価格・特徴の3列の表にして出力してください」 |
試験では、1つのプロンプト全文を示して「【 】で囲んだ部分にあたる要素は?」「Instructionに当たる部分として最も適切なものは?」という形で問われます。見分け方はこうです。
- 「〜してください」という動作の依頼 → Instruction
- 「あなたは〜です」「相手は〜です」という立場・読み手の説明 → Context
- 会議の記録・問い合わせ文・規程の条文など、処理される中身そのもの → Input Data
- 「箇条書きで」「3行以内で」「表にして」という形の指定 → Output Indicator
ContextとInstructionは混ざりやすいですが、立場の説明がContext、やることの依頼がInstructionです。「あなたは新人研修の講師です」はContext、「やさしく言い換えてください」がInstructionです。
Zero-ShotとFew-Shot
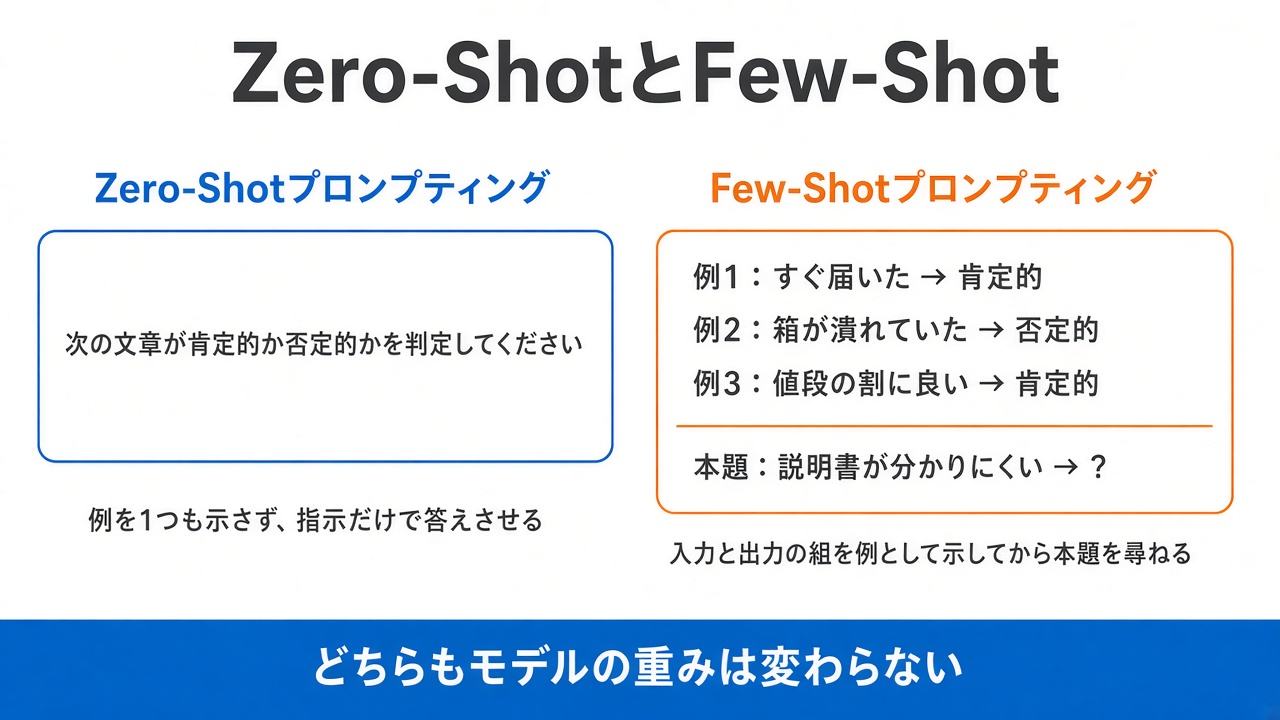
図:左がZero-Shot。例を1つも示さず、指示だけで答えさせます。右がFew-Shot。入力と出力の組をいくつか例として示してから本題を尋ねます。どちらもモデルの重みは更新されません。
Zero-Shotプロンプティングは、入力と出力の例を1つも示さずに、指示だけで作業をさせる書き方です。「次の文章が肯定的か否定的かを判定してください」のような形です。
Few-Shotプロンプティングは、プロンプトの中に入力と出力の組をいくつか例として示してから本題を尋ねる書き方です。問い合わせの内容を「製品」「配送」「その他」に分類させるとき、分類済みの例を3件書き添えてから本題を尋ねる、というのがこれにあたります。
Few-Shotの特徴として問われるのは次の2点です。
- 追加の学習でパラメータを更新することなく、プロンプト内の例を手がかりにタスクへ適応させる
- 分類の基準や出力の形式を、言葉で説明しにくいときに、例を通して伝えられる
1つ目が重要です。Few-Shotはモデルの重みを一切変えません。ファインチューニング(重みを変える追加学習)との違いがここです。第2章・第3章で出てきた「重みを変えるか、外から渡すか」という軸が、第5章でも効いてきます。
実践:使い方の名前を場面から選ぶ
ここからは、使い方に付けられた名前を覚える部分です。数が多いので、性質ごとにまとめます。
ここから先は、ほかの資格では見かけない範囲です。前半のZero-ShotとFew-Shotはクラウド各社のAI入門資格にも出てきますが、メールの作成、キャッチコピー、姓と名の分離、ふりがなの記載といった業務での使い方に名前が付いているのは、筆者が受けてきたなかではこの試験だけでした。技術の資格の感覚で読むと、覚える対象に見えないまま通り過ぎてしまいます。名前が付いている以上は問われる、と割り切って拾ってください。
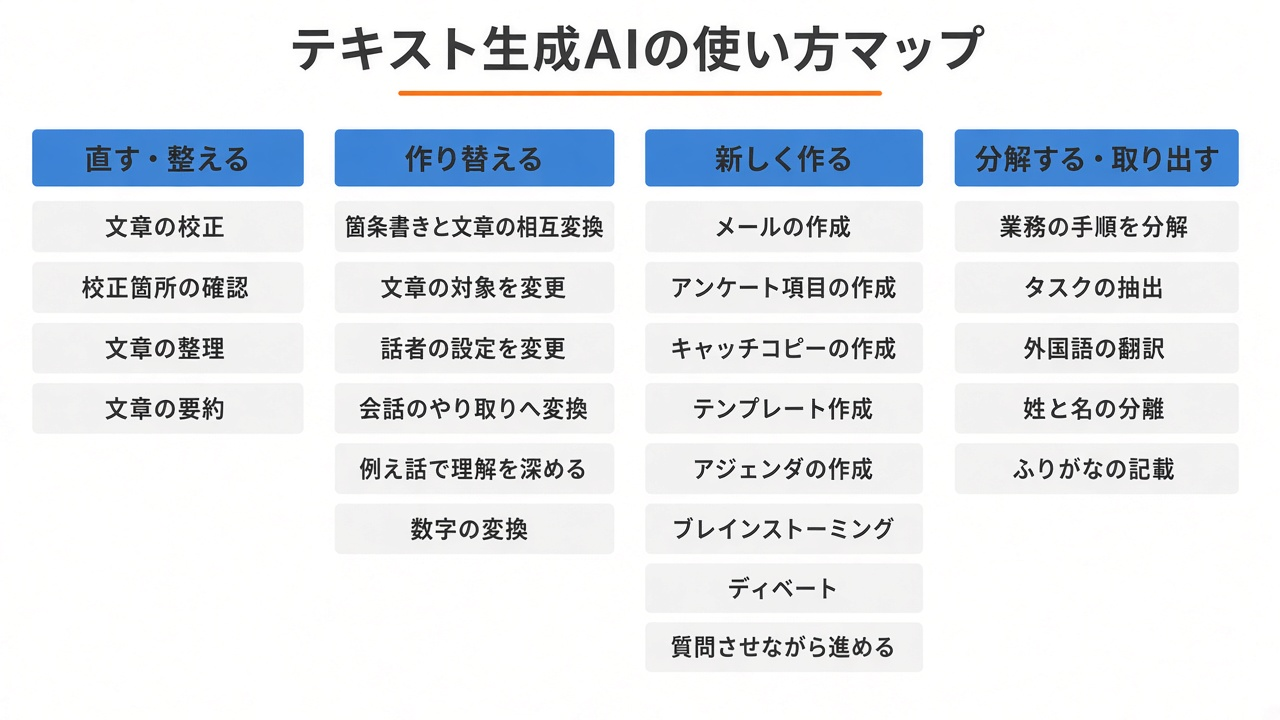
図:第5章で名前が問われる使い方を、「直す」「作り替える」「新しく作る」「分解する」の4つに分類したもの。場面を読んで名前を選ぶ問題では、まずこの4分類のどれかを特定してから、その中で選ぶと速く絞れます。
文章を「直す」「整える」
| 使い方 | 場面 |
|---|---|
| 文章の校正 | 文章の中の誤字脱字や表現の乱れを見つけて直す |
| 校正箇所の確認 | 校正のあとで「どこをどう直したのか、理由とあわせて一覧にしてください」と続けて頼む |
| 文章の整理 | 話題があちこちに飛んでいるメモを、内容は変えずに話題ごとにまとめ直す |
| 文章の要約 | 長い文章から重要な点だけを取り出して短くまとめる |
校正と校正箇所の確認は別の名前である点に注意してください。直す作業が校正、直した内容を一覧にさせるのが校正箇所の確認です。社外に出す文章では、どこを変えたのか分からないまま出すわけにいかないため、この2段構えが実務でも効きます。
適したプロンプトを選ばせる問題も出ます。校正では「次の文章の誤字脱字と敬語の誤りを直し、変更点を『修正前→修正後』の形で一覧にしてください」のように、出力形式まで指定しているものが正解です。要約では「誰に向けた要約か、何字程度か、どの観点を残すかを書き添える」が正解になります。
文章を「作り替える」
| 使い方 | 場面 |
|---|---|
| 箇条書きを文章に変換/文章を箇条書きに変換 | 会議のメモを報告書に使える文章に直す/説明文を情報を落とさず箇条書きにする |
| 文章の対象を変更する | 専門用語の多い説明文を「小学生にも分かる言葉と内容に書き直してください」と頼む |
| 話者の設定を変更する | 「あなたは調達部門のリーダーです」のように立場や役割を与えて、その立場から答えさせる |
| 文章を会話のやり取りへ変換 | 製品の使い方の説明文を、利用者が質問し担当者が答える会話の形に書き直す |
| 例え話で理解を深める | 「貸し倉庫を借りるときの話に置き換えて説明してください」と頼む |
| 数字の変換 | 「千二百五十円」「1250円」「1.25千円」とばらばらな表記を「1,250円」にそろえる |
「対象を変更する」と「話者の設定を変更する」が混ざりやすいところです。読み手を変えるのが対象の変更、答える側の立場を変えるのが話者の設定です。「小学生にも分かるように」は読み手の変更なので対象の変更、「あなたは経験10年の品質管理の担当者です」は答える側の設定なので話者の設定変更です。
ビジネスで「新しく作る」
| 使い方 | 場面 |
|---|---|
| メールの作成 | 宛先や用件を伝えて、下書きを作らせる |
| 海外企業宛のメール文章の作成 | 日本語の用件を伝えて、先方の商習慣に合う英文メールを作らせる |
| アンケート項目の作成 | 聞くべき質問の候補とその選択肢を挙げさせる |
| アンケートの分析 | 自由記述の回答をまとめて渡し、分類の観点と出力の形式を指定して整理させる |
| キャッチコピーの作成 | 商品の特徴と届けたい相手、字数の上限を伝えて、案を複数出させて選ぶ |
| ビジネス書類のテンプレート作成 | 必要な項目と記入例を伝え、空欄に書き込む形の雛形を作らせる |
| アジェンダの作成 | 議題と時間配分の案を出させ、会議の進行表の下書きを作らせる |
| 英単語から英文の作成 | 覚えたい単語を渡し、その単語を使った短い例文を作らせる |
| ブレインストーミング | 条件を伝えて案を10件出させ、気に入った案から切り口を変えた派生案を出させる |
| ディベートを行う | 賛成と反対の立場からそれぞれ意見を出させ、互いの主張への反論も書かせて論点を検討する |
| 質問させながら一緒に進める | 「書き始める前に、足りない情報があれば私に1つずつ聞いてください」と書き添える |
ここで問われる「最も適切な進め方」には共通の型があります。条件(特徴・相手・字数)を伝え、複数案を出させて人が選ぶ、という形です。「1案だけ出させてそのまま使う」「条件を伝えずに任せる」という選択肢は誤りになります。
筆者の経験では、この章で名前が付いている使い方のうち、いちばん効き目が大きいのは「質問させながら一緒に進める」です。最初はプロンプトに条件を細かく書き込むほど良い結果が出ると思っていましたが、書き込みすぎると出力が自分の想像の範囲から出てこなくなります。今は、こちらが考えきれていない部分は「足りない情報を聞いてください」と投げてしまい、問いを立ててもらう形に変えました。経験のある人に作業を頼むとき、手順をすべて指定するより「一緒に考えてほしい」と頼んだほうが良い案が出てくるのと、構造は同じです。
文章を「分解する」
| 使い方 | 場面 |
|---|---|
| 業務の手順を分解 | 「新しい社内システムを導入する」という大きな作業を、着手できる大きさに分けて順番に並べさせる |
| タスクの抽出 | 議事録のような長い文章から、次に行うべき作業だけを一覧として取り出す |
| 外国語の翻訳 | 日本語の文章を、意味を保ったまま別の言語に置き換える |
| 姓と名の分離 | 「山田太郎」のような氏名を、区切りがなくても姓と名の境目を推定して2列に分ける |
| ふりがなの記載 | 漢字の氏名に、読み方を添えた列を作らせる |
手順の分解とタスクの抽出も混ざりやすいところです。まだ存在しない手順を作り出すのが手順の分解、すでにある文章から拾い出すのがタスクの抽出です。議事録が素材になっていればタスクの抽出です。
苦手なこと:名前ではなく「理由」が問われる
第5章の最後の中項目は、出題の形が特徴的です。「苦手なことは何か」だけでなく、「なぜそうなるのか」まで問われます。
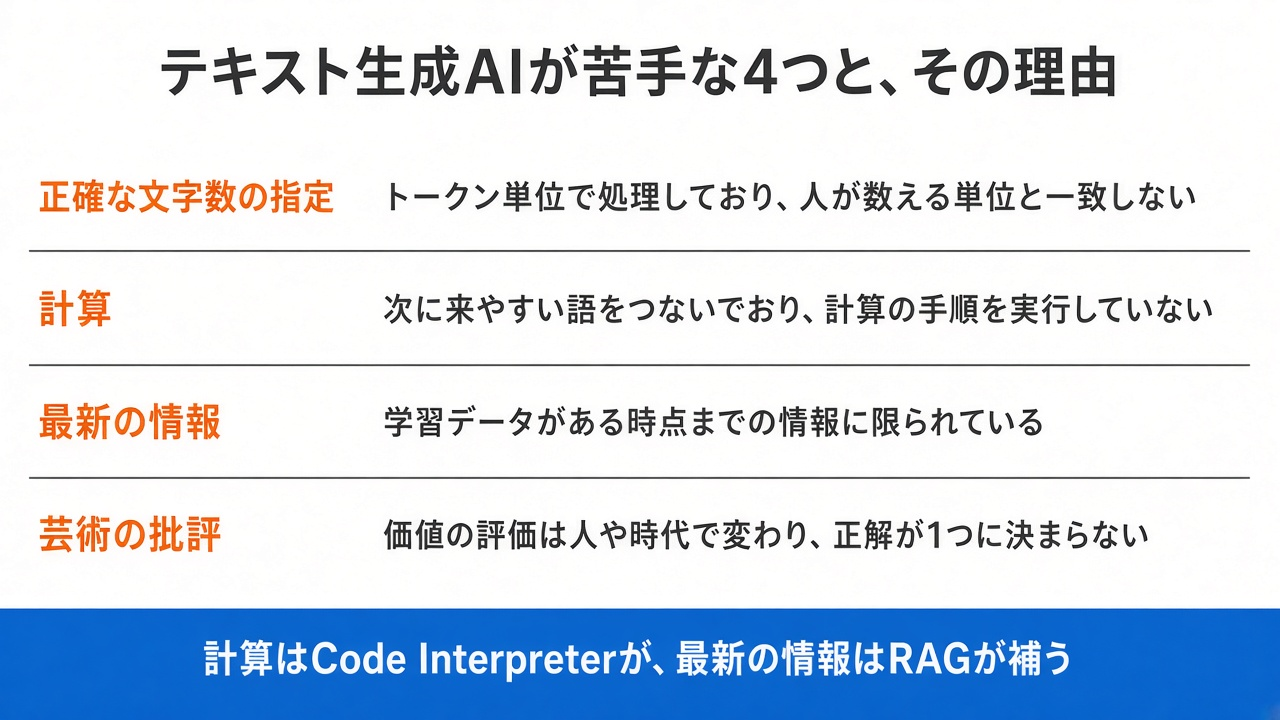
図:苦手な4つと、それぞれの理由。トークン単位で処理しているから文字数が合わず、次に来やすい語をつないでいるから計算ができず、学習データが一時点までだから最新情報を知らず、正解が1つに定まらないから芸術の批評に向きません。
| 苦手なこと | 理由 |
|---|---|
| 正確な文字数の指定 | 文章をトークンという単位に分けて処理しており、トークンの区切りは人が数える言葉の単位と1対1に対応していないから |
| 計算 | 次に来やすい語をつないで答えを作っており、計算の手順を実行していないから |
| 最新の情報 | 学習データが、ある時点までの情報に限られているから |
| 芸術の批評 | 価値の評価は見る人や時代によって変わり、一つの正解が決まらないから |
計算の理由は、実例とセットで出ます。「見積書に並んだ20件の金額を渡して合計を出させたら、実際の合計と数百円ずれた」という場面で、原因を問う形です。答えは「次に来やすい語をつないで答えを作っており、計算の手順を実行していないから」です。
なお、第2章で扱ったCode Interpreterは、プログラムをその場で書いて実行することでこの弱点を補う機能です。また、第3章のRAGは「最新の情報」の弱点を補う手法です。苦手なことと、それを補う仕組みが対応しているという見方ができると、章をまたいだ理解になります。
芸術の批評については、「複数の絵画を、芸術としての価値が高い順に順位付けする」という作業が向かない例として出ます。事実ではなく価値判断だから、というのが理由です。
第5章の形式に合わせた例題3問
例題1:プロンプトの要素を特定する
問題: ある採用担当者が、次の4つの文を続けて書いたプロンプトを使いました。このうち、Output Indicator(出力指示子)に当たる部分として最も適切なものを1つ選びなさい。
- あなたは採用担当者です。応募者は大学3年生です。
- 次の求人票を、応募者が読んで理解しやすい文章に書き直してください。
- 求人票:「当社は社会インフラ向けシステムの受託開発を主たる事業とする」
- 出力は3つの箇条書きにしてください。
- あなたは採用担当者です。応募者は大学3年生です。
- 次の求人票を、応募者が読んで理解しやすい文章に書き直してください。
- 求人票:「当社は社会インフラ向けシステムの受託開発を主たる事業とする」
- 出力は3つの箇条書きにしてください。
答え:4
出力の形式や種類を指定している部分がOutput Indicatorです。1は立場と読み手の説明なのでContext、2は実行してほしい作業の依頼なのでInstruction、3は処理の対象となる素材そのものなのでInput Dataです。4要素がすべて揃った、よくできたプロンプトの例でもあります。
例題2:書き方の名前を選ぶ
問題: 社内に届く問い合わせメールを「見積依頼」「不具合報告」「その他」に分類させたいと考えています。分類の基準を言葉で説明するのが難しかったため、すでに分類済みのメール3件を、本文と分類結果の組にしてプロンプトに書き添えてから本題を尋ねました。この書き方に該当するものを1つ選びなさい。
- Zero-Shotプロンプティング
- Few-Shotプロンプティング
- ファインチューニング
- プレトレーニング
答え:2
入力と出力の組をいくつか例として示してから本題を尋ねる書き方がFew-Shotプロンプティングです。1のZero-Shotは例を1つも示さない書き方なので当てはまりません。3のファインチューニングは追加のデータでモデルの重みを更新する手法で、プロンプトに例を書くこととは別物です。4のプレトレーニングはモデルを作る最初の段階の学習で、利用者が行うものではありません。
例題3:苦手なことの理由を選ぶ
問題: 経費精算の一覧にある35件の金額をテキスト生成AIにそのまま渡して合計を出させたところ、実際の合計と1,000円ほどずれた答えが返ってきました。この原因の説明として、最も適切なものを1つ選びなさい。
- 学習データがある時点までの情報に限られているから
- 次に来やすい語をつないで答えを作っており、計算の手順を実行していないから
- Temperatureの値が低く設定されていたから
- 入力した金額が個人情報にあたり、処理が制限されたから
答え:2
テキスト生成AIは、次に来る語の確率をもとに文章を組み立てる仕組みです。数値の計算を手順として実行しているわけではないため、桁数が多かったり件数が多かったりすると答えがずれます。1は「最新の情報」が苦手な理由で、この場面には当てはまりません。3のTemperatureは出力のばらつきを調整する値で、計算の正確さとは関係がありません。4は、個人情報の扱いの話であって、計算結果がずれる理由にはなりません。
本番形式の360問で仕上げる
生成AIパスポート 模擬試験360問(本番形式60問×6回)【2026年シラバス対応】
本番と同じ60問・60分の模擬試験を6回分、全360問。全問を2026年シラバスから書き下ろし、RAG・AIエージェント・MCP・AI新法といった追加範囲も含めています。正解・不正解を問わず全選択肢に解説をつけているので、間違えた理由がその場で分かります。
当ブログ限定クーポン:通常 2,600円 → 1,500円
よくある質問
Q. 使い方の名前が多すぎて覚えられません。
全部を丸暗記する必要はありません。場面を読んだときに「直す/作り替える/新しく作る/分解する」のどれかをまず判定し、その中で選べば、選択肢は実質2つか3つに絞れます。混ざりやすいのは「対象の変更と話者の設定」「手順の分解とタスクの抽出」「校正と校正箇所の確認」の3組だけなので、ここを重点的に押さえてください。
Q. TemperatureとTop-pは、どちらをどう使い分けるのですか?
試験では使い分けの判断までは問われません。それぞれの説明と、値を下げたときに出力のばらつきが小さくなるという変化が分かれば足ります。実務では、事実を扱う作業では低めに、アイデア出しでは高めに、という使い分けが一般的です。
Q. プロンプトは長く詳しく書くほどよいのですか?
試験で問われる「適切なプロンプト」は、4要素(指示・文脈・入力・出力形式)が揃っているものです。その意味では、条件を書き添えたほうが正解になります。ただし実務では、書き込みすぎると出力が自分の想定の範囲から出てこなくなる、という副作用もあります。形式や制約は具体的に、中身の発想は余白を残して、という使い分けが現実的です。
Q. 第5章だけ勉強すれば、実務ではすぐ使えますか?
使えます。実際、第5章の内容は資格を取らなくても業務に直結します。ただし、第4章の個人情報と権利の知識がないまま使い始めると、入力してはいけないものを入力してしまうことがあります。実務で使うという目的であっても、第4章と第5章はセットで学ぶのをおすすめします。
まとめ
- 言語モデルは「次に来る語の確率を出すもの」。n-gram(数え上げ)→ニューラル言語モデル(ベクトル)→LLM(量が桁違い)という発展
- パラメータは学習で決まる値、ハイパーパラメータは人が設定する値
- Temperatureは確率の偏りを調整、Top-pは候補の範囲を確率の合計で区切る。どちらも下げるとばらつきが小さくなる
- プロンプトの4要素は、依頼=Instruction、立場・読み手=Context、素材=Input Data、形式=Output Indicator
- Zero-Shotは例なし、Few-Shotは例あり。Few-Shotはモデルの重みを変えない
- 使い方は「直す/作り替える/新しく作る/分解する」で分類してから選ぶ
- 混ざりやすいのは「対象の変更と話者の設定」「手順の分解とタスクの抽出」「校正と校正箇所の確認」の3組
- 苦手な4つは理由までセットで。文字数=トークン単位、計算=語をつないでいるだけ、最新情報=学習時点まで、芸術の批評=正解が1つに定まらない
これで全5章の整理は終わりです。試験の概要、学習の順番、各章の復習は親記事にまとめています。
▶ 生成AIパスポート試験の出題範囲を章別に学ぶ|5章まとめと学習ロードマップ
前の章はこちらです。
▶ 生成AIパスポート 第4章「情報リテラシーとAI社会原則」の要点|個人情報保護法・著作権・AI新法
最後までお読みいただきありがとうございました。
この記事がお役に立ちましたら、コーヒー1杯分(300円)の応援をいただけると嬉しいです。いただいた支援は、より良い記事作成のための時間確保や情報収集に活用させていただきます。
システムエンジニア
AWSを中心としたクラウド案件に携わっています。
IoTシステムのバックエンド開発、Datadogを用いた監視開発など経験があります。
IT資格マニアでいろいろ取得しています。
AWS認定:SCS, ANS, AIP, SAP, DOP, SAA, DVA, SOA, CLF
Azure認定:AZ-104, AZ-300
ITIL Foundation
Oracle Master Bronze (DBA)
Oracle Master Silver (SQL)
Oracle Java Silver SE
■略歴
理系の大学院を卒業
IT企業に就職
AWSのシステム導入のプロジェクトを担当