当ブログにはPRを含みます。
ChatGPTを毎日使っていても、なぜ間違ったことをもっともらしく言うのかを説明しようとすると、詰まることがあります。TemperatureとTop-pの違いも、聞かれた瞬間に止まりやすいところです。第2章で止まるのは、だいたいこのあたりです。
第2章「生成AI」は、2027年2月試験から適用される新しいシラバスで大きく作り直された章です。旧シラバスではモデルの名前と系譜を覚える章でしたが、新シラバスでは、現在の生成AIを「技術・学習・生成」の流れで捉える構成になりました。Transformer以降の技術革新、事前学習からRLHFまでの学習プロセス、次のトークンを確率的に選ぶ生成の仕組み、LLMの利用形態、主要なモデルの動向、画像・音声・動画の生成AIまでが範囲です。
改訂の意図として公式が挙げているのは、「生成AIをブラックボックスとして利用するのではなく、学習や生成の基本原理を理解することで、なぜ誤った出力が生じるのかといった特性を捉える」ことです。この記事でも、名前の暗記より先に、仕組みを1つの流れでつなぐほうから書きます。
シリーズの第2章です。前の章は、機械学習とニューラルネットワークの基礎、CNN・RNN・VAE・GANです。
第2章で問われるのは「生成AIがどう学び、どう作るか」
中項目ごとの出題のされ方
新シラバスの第2章は6つの中項目に分かれています。
| 中項目 | 主な用語 | 問われ方 |
|---|---|---|
| 生成AIを支える技術革新 | Transformer、Self-Attention、Query・Key・Value、拡散モデル、潜在拡散モデル、基盤モデル、マルチモーダルモデル | 仕組みの説明を選ぶ/何が変わったかを選ぶ |
| 生成AIの学習プロセス | 事前学習、次トークン予測、ファインチューニング、指示チューニング、ドメイン適応、RLHF、報酬モデル、スケーリング則、創発的能力 | 段階の順序/各段階で何を使うか |
| 生成AIの生成(推論)プロセス | トークン化、埋め込み、確率分布、ハルシネーション、Temperature、Top-p、コンテキストウィンドウ | 誤った出力が起きる理由/値を変えたときの変化 |
| LLMの基礎 | LM、LLM、クラウド型LLM、オンプレミスLLM、データ主権、オープンウェイト、ライセンス | 違いを選ぶ/条件に合う利用形態を選ぶ |
| ChatGPTと主要な生成AIモデルの動向 | GPTの各世代、推論モデル、思考の連鎖、Operator、Codex、Image Generation、Gemini、Claude、Copilot | 世代と特徴の対応/提供企業との対応 |
| 各モダリティの生成AI | 画像・音楽・音声・動画の生成AI、インペインティング、電子透かし、C2PA、ニューラルTTS、Voice Cloning、本人の同意 | できること/使うときの注意点 |
旧シラバスにあったボルツマンマシン、RoBERTa・ALBERT、BERTの学習課題(MLM・NSP)、Code InterpreterやGPTsといった個別の機能名は、新シラバスの用語から外れました。CNN・RNN・VAE・GANは第1章に移っています。
第2章を解く軸は「学習の段階」と「確率で選んでいること」
1つ目は、学習のどの段階の話かです。大量の文章で言葉の知識を身につけるのが事前学習、指示に答える形に整えるのがファインチューニング、人の評価で好ましい回答に近づけるのがRLHF。段階を取り違えた選択肢が、よく混ざります。
2つ目は、生成AIが次のトークンを確率で選んでいることです。ハルシネーションが起きる理由も、TemperatureやTop-pで出力が変わる理由も、同じ回答が毎回少しずつ違う理由も、ここから説明できます。
生成AIを支える技術革新:Transformer以降
Transformer:全体の関係を一度に計算する
2017年に発表されたTransformerは、今の生成AIのほぼすべてが土台にしているモデルです。それまで文章の処理で主流だったRNNは、単語を1つずつ順番に処理するため、計算を並列に進めにくく、文が長くなると離れた単語の情報が薄れる弱点がありました。
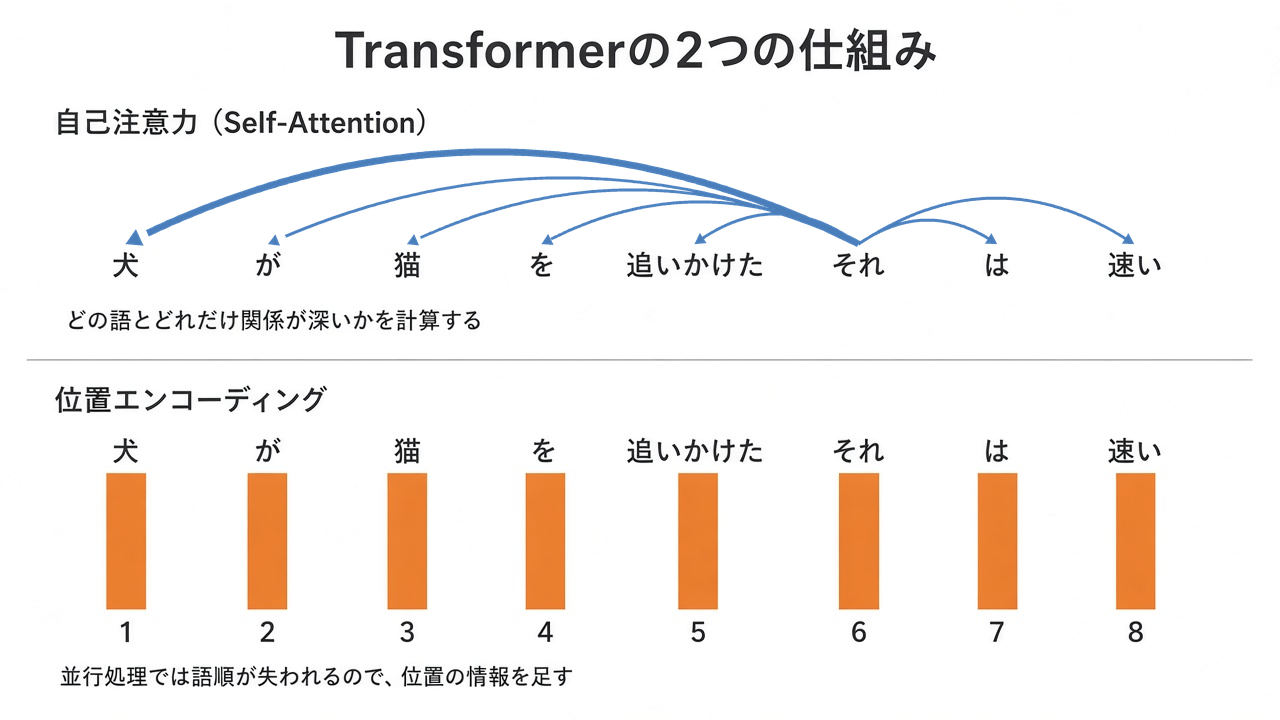
自己注意力(Self-Attention)は、「それ」が文中のどの語を指すのかを、語どうしの関係の強さとして計算します。位置エンコーディングは、単語を並行して処理すると語順が失われるので、各単語に「何番目か」を足してから入力する仕組みです。
Transformerの中核はSelf-Attention(自己注意機構)です。文中の各単語が、同じ文のほかのどの単語にどれだけ注目すべきかを、すべての組み合わせについてまとめて計算します。この計算は、各単語から作るQuery・Key・Valueという3つのベクトルで行われます。
- Query:自分が何を探しているか
- Key:自分が何者か(ほかの単語のQueryと照らし合わされる)
- Value:注目されたときに渡す中身
図書館の調べものにたとえると、Queryが「探している内容」、Keyが「本の背表紙の見出し」、Valueが「本の中身」です。探している内容と見出しを比べて、関係の深い本ほど重視して中身を取り入れます。
順番に処理する必要がないため並列処理に向き、離れた位置の単語どうしの関係(長距離依存)もとらえやすくなりました。大量のデータで大規模なモデルを学習できるようになったことが、LLMの時代を開きました。
Transformerから派生したモデルには、前後両方の文脈を使って文の意味を読み取るBERT(Google)と、前から順に次の語を予測して文章を書き足すGPT(OpenAI)の2つの系統があります。
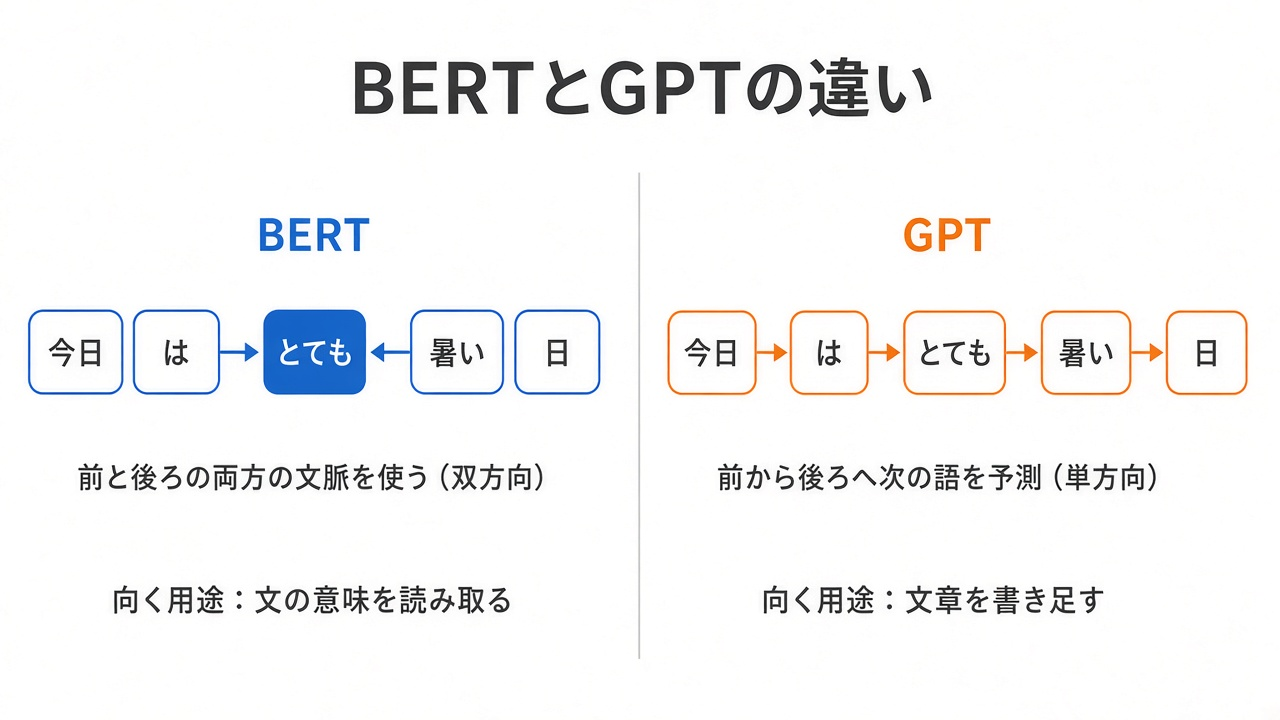
BERTは、ある語の意味をとらえるとき、前と後ろの両方の文脈を同時に使います。GPTは、前から後ろへ向かって次の語を予測します。得意な用途の違いは、ここにあります。
拡散モデル:ノイズを少しずつ取り除いて作る
画像生成AIの多くが土台にしているのが拡散モデル(Diffusion Model)です。
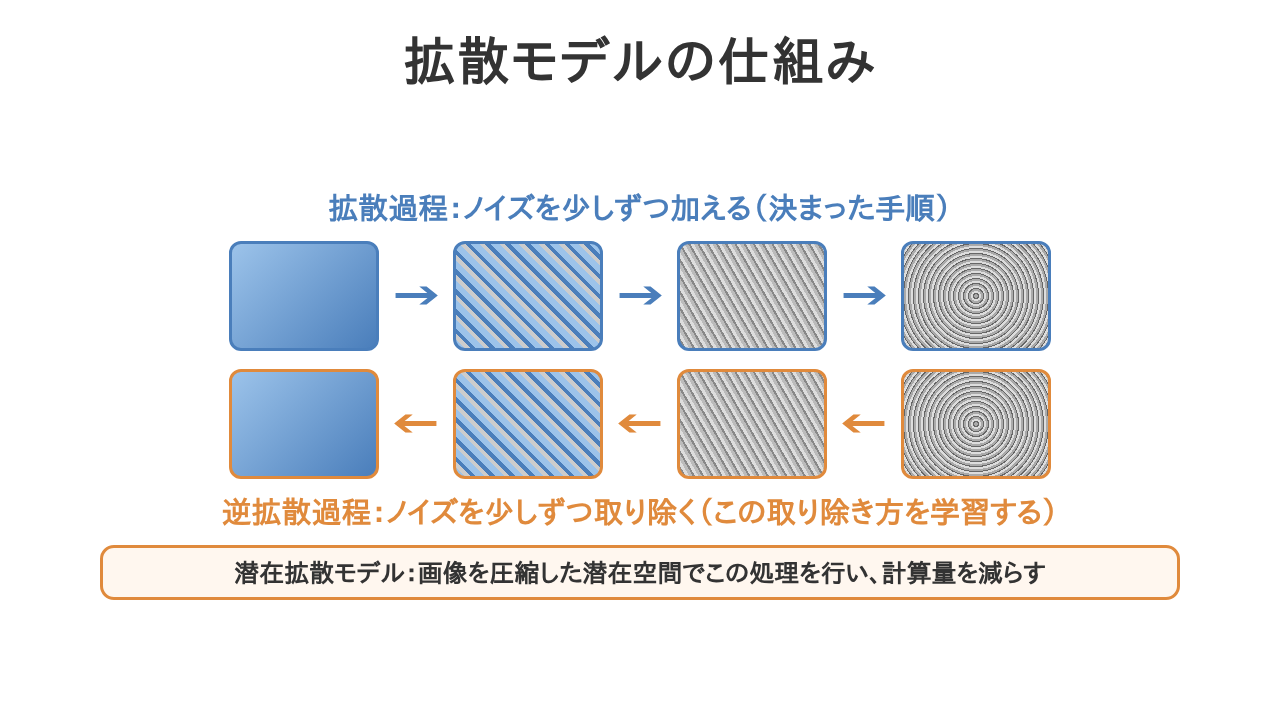
拡散過程では、画像にノイズを少しずつ加え、最後はノイズだけにします。逆拡散過程では、ノイズだけの状態から、少しずつノイズを取り除いて画像を作ります。モデルが学習するのは、このノイズの取り除き方です。
- 拡散過程:画像にノイズを段階的に加えていく過程。決まった手順で行うため学習の対象ではない
- 逆拡散過程:ノイズを段階的に取り除いて画像に戻す過程。この取り除き方をモデルが学習する
生成時は、ランダムなノイズから出発して逆拡散過程を繰り返し、新しい画像を作ります。潜在拡散モデル(Latent Diffusion Model)は、画像をエンコーダで小さな潜在表現に圧縮し、その中で拡散と逆拡散を行うことで計算量を大きく減らした方式で、Stable Diffusionとして広く普及しました。
第1章のGAN(生成器と識別器を競わせる)、VAE(圧縮と復元)との違いは、ノイズを段階的に取り除いて作るかどうかで分けられます。
基盤モデルとマルチモーダル化
基盤モデル(Foundation Model)は、大量で多様なデータで大規模に事前学習され、追加の学習やプロンプトの工夫によって、要約・翻訳・質問応答など幅広いタスクに応用できるモデルです。家の基礎の上にいろいろな建物を建てられるように、1つの基盤モデルの上で多様な用途を実現できます。
モダリティはテキスト・画像・音声・動画といったデータの種類のことで、複数のモダリティを扱えるモデルをマルチモーダルモデルと呼びます。写真を見せて質問する、音声で会話する、文章から画像を作る、といったことができます。日本語と英語を扱えることは「多言語対応」で、マルチモーダルとは別の話です。
生成AIの学習プロセス:3つの段階
事前学習・ファインチューニング・RLHF
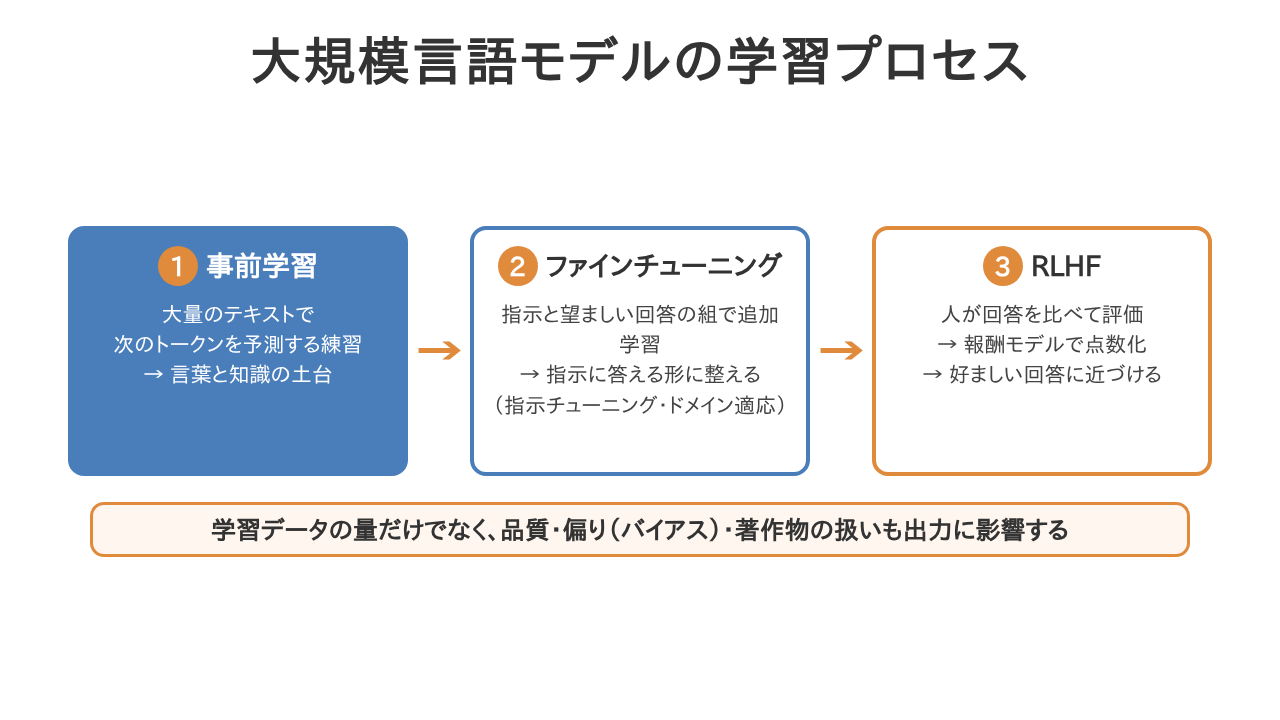
対話型のLLMは、事前学習で言葉の知識を身につけ、ファインチューニングで指示に答える形に整え、RLHFで人が好ましいと感じる回答に近づける、という3段階で作られます。
| 段階 | 使うもの | 身につけること |
|---|---|---|
| 事前学習 | 大量のテキスト | 次のトークンを予測する練習を繰り返し、文法や幅広い知識を身につける |
| ファインチューニング | 目的に合ったデータ(指示と望ましい回答の組など) | 指示に答える振る舞い。多様なタスクの指示と回答で学ぶものを指示チューニング、医療や法律など特定分野のデータで学ぶものをドメイン適応と呼ぶ |
| RLHF | 人が回答を比べて付けた評価 | 人が好ましいと感じる、有用で安全な回答の出し方 |
RLHF(人間のフィードバックによる強化学習)は、少し仕組みを見ておきます。まず同じ質問に対する複数の回答を人が比べて順位を付け、その評価の傾向を学んだ報酬モデルを作ります。そのうえで、報酬モデルの点数が高くなるように、対話モデルを強化学習で調整します。
段階の順序はよく問われます。「ファインチューニングを事前学習の前に行う」「RLHFを最初に行う」といった並べ方は誤りです。前の段階の成果を土台に次の段階がある、という関係で覚えます。
学習データの規模と課題
スケーリング則は、モデルのパラメータ数・学習データの量・計算量を大きくすると、誤差がおおむね予測可能な形で小さくなっていくという経験則です。LLMの大規模化を後押ししました。創発的能力は、規模がある点を超えると、小さなモデルでは見られなかった能力が現れるように見える現象です。「なだらかな改善(スケーリング則)」と「急に現れる能力(創発的能力)」で区別します。
量だけでなく、データの品質も重要です。学習データに含まれる誤りや偏り(バイアス)は、モデルの出力に引き継がれます。著作物を含むデータを学習に使うことについては、第4章で扱う著作権の考え方も関係します。
生成(推論)プロセス:次のトークンを確率で選ぶ
トークン化・埋め込み・次トークン予測
LLMは、入力された文章を次の順で処理します。
- トークン化:文章をトークンという単位に区切る。よく出る語はひとまとまり、まれな語は小さな部品(サブワード)に分ける
- 埋め込み(Embedding):各トークンを、意味の近いものが近くに並ぶ数値の並び(ベクトル)に変換する
- 次トークン予測:それまでの文に続くトークンの候補それぞれに確率を割り当て(確率分布)、その確率に従って1つ選ぶ
- 選んだトークンを末尾に足し、3に戻る
APIの利用料金や、一度に扱える量の上限は、文字数ではなくトークン数で決まることが多く、同じ内容でも言語によってトークン数が変わります。
ハルシネーションは「確率で選んでいる」ことから起きる
ハルシネーション(Hallucination)は、事実ではない内容を、もっともらしい文章として出力してしまうことです。新シラバスでは、「なぜ起きるのか」まで問われます。
答えは、生成の仕組みそのものにあります。LLMは「事実として正しいか」ではなく「文脈に続く語として確率が高いか」でトークンを選んでいます。そのため、知識が不確かな話題でも、自然な文章を組み立ててしまいます。「分からない」と答えるより、それらしい答えを出すほうが評価されやすい学習のされ方も、原因の一つと指摘されています。
私は資格試験の教材を作る仕事で生成AIを使っていますが、この弱点には何度も遭遇しています。たとえばクラウドの権限設定について尋ねたとき、「拒否と許可が両方設定されていれば、結果的に許可になる」と説明されたことがありました。実際は逆で、拒否が最優先されます。ほかにも、サービスの仕様が変わったあとも古い仕様のまま答え続ける、ということが何度もありました。
怖いのは、こちらに知識があったから気づけただけ、ということです。知らない分野で同じことをされていたら、そのまま信じていたはずです。今は、事実関係については根拠となる一次情報を示させ、そこに当たって確かめる手順を入れています。「もっともらしいから正しいとは限らない」は、試験で問われる定義であると同時に、使う側が持っておくべき前提でもあります。対策としては、信頼できる文書を参照させるRAG(第3章)、出典を示させること、人によるファクトチェック(第4章)を組み合わせます。
TemperatureとTop-p:確率の選び方を調整する
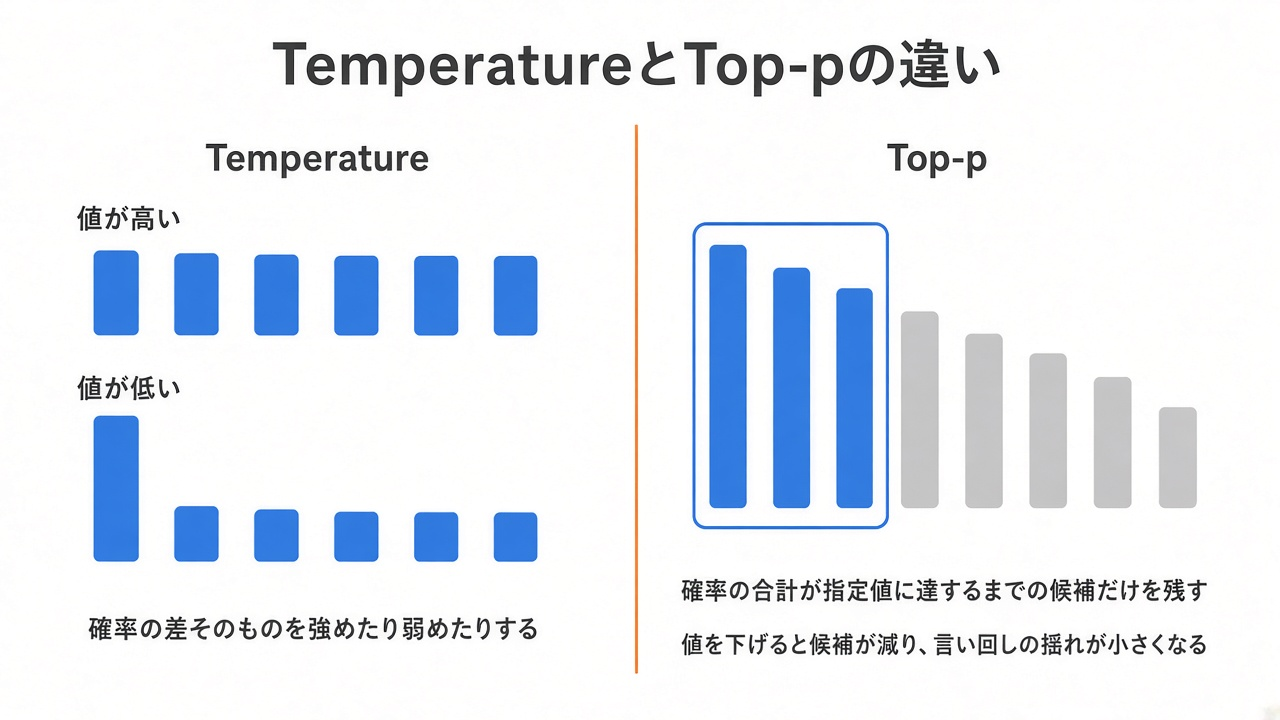
Temperatureは、次に来る語の確率の差そのものを強めたり弱めたりします。Top-pは、確率の高い順に候補を足し合わせていき、合計が指定した値に達するまでの候補だけを選択肢に残します。どちらも出力のばらつきを調整しますが、効かせ方が違います。
Temperatureは、次のトークンの確率分布の偏りを強めたり弱めたりして、出力のランダムさの度合いを調整する生成パラメータです。値を下げると確率の高い語に寄りやすくなり、上げると言い回しの揺れが大きくなります。
Top-pは、次のトークンの候補を確率の高い順に並べて足し合わせ、その合計が指定した値に達するまでの候補の中から選ぶようにする生成パラメータです。値を1から0.1に下げると、出やすさの高い一部の候補からだけ選ばれ、言い回しの揺れが小さくなります。
同じプロンプトでも回答が毎回少しずつ違うのは、この確率的な選び方のためです。事実を扱う作業ではばらつきを小さく、アイデア出しでは大きく、と用途で使い分けます。
私は、中古のゲーミングノートPCでローカルLLMを動かしてみたことがあります。手元で動かすと、Temperature や Top-p のつまみが設定画面にそのまま並んでいて、値を変えながら同じ質問を何度も投げられます。クラウドのサービスでは、これらは裏に隠れているので、言葉として覚えるしかありません。自分で動かしてみると、Temperature を上げたときの「言い回しが散る」感じが残ります。試験では定義が言えれば十分です。
▶ 中古ゲーミングPCでローカルLLMはどこまで使える?つまずいた6つのポイントと正直な感想
コンテキストウィンドウ
コンテキストウィンドウは、LLMが一度に処理できるトークン数の上限です。入力したプロンプトだけでなく、会話の履歴、添付した資料、生成する出力も含まれます。会話が長くなって上限を超えると、最初のほうで伝えた条件が参照されなくなることがあります。上限の中でも、情報が多すぎると重要な部分が埋もれやすくなります。この考え方は、第3章のAIエージェントの「コンテキスト管理」につながります。
LLMの基礎:LMとLLM、利用形態
言語モデルとは「次に来る言葉の確率を出すもの」
LM(言語モデル)は、ある言葉の並びに続いて、次にどの言葉が来やすいかを確率で表すモデルをまとめて指す言葉です。
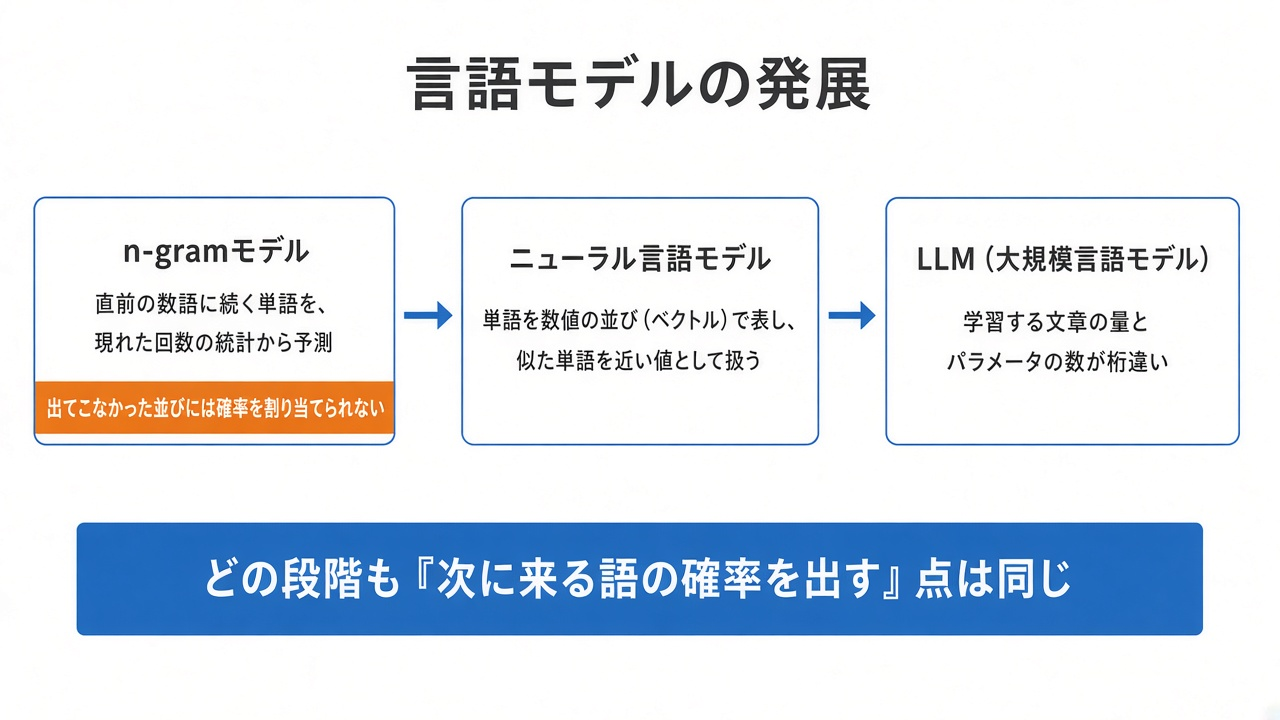
n-gramモデル(数え上げ)から、ニューラル言語モデル(単語をベクトルで表す)を経て、LLM(大量の文章と桁違いのパラメータ)へ。どの段階でも「次に来る語の確率を出す」という本質は変わりません。変わったのは、確率の求め方と規模です。
LLM(大規模言語モデル)は、大量の文章で学習し、非常に多くのパラメータを持つことで、要約や翻訳など幅広い作業を1つのモデルでこなせるようになった言語モデルです。「大規模」と呼ばれる理由は、学習に使う文章の量と、モデルが持つパラメータの数が桁違いに多いからです。
クラウド型LLMとオンプレミスLLM
新シラバスで加わったのが、LLMの利用形態です。
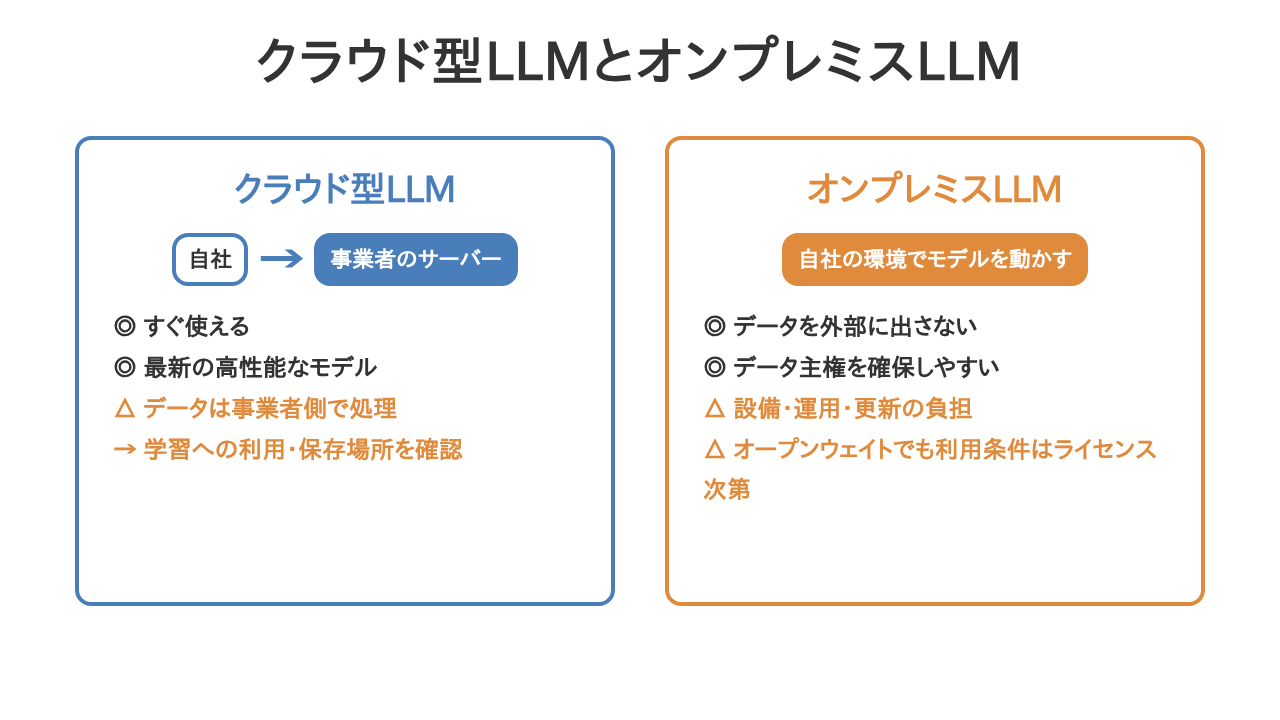
クラウド型LLMは提供事業者のサーバーで動き、すぐに使えて最新のモデルを利用しやすい反面、データは事業者側で処理されます。オンプレミスLLMは自社の環境で動かすため、データを外部に出さずに処理できる反面、設備と運用の負担があります。
| クラウド型LLM | オンプレミスLLM(ローカルLLM) | |
|---|---|---|
| 動く場所 | 提供事業者のサーバー | 自社のサーバーや管理下の環境 |
| 利点 | すぐ使える、最新の高性能なモデルを使いやすい | データを外部に送らずに処理できる |
| 注意点 | 入力データの扱い(学習への利用、保存場所)を確認する | 計算機の用意、運用・更新の負担。使えるモデルが限られる |
データ主権は、データをどこに保存し、どこで処理し、誰が扱えるかを、自らの管理下に置くという考え方です。機密性の高いデータを扱う業種で、オンプレミスLLMが選ばれる理由の一つです。
オープンウェイトは、学習済みモデルの重みが公開され、自社の環境に導入して動かせる状態を指します。重みが公開されていても、商用利用の可否などの条件はモデルごとのライセンスで決まります。「公開されているから、どの用途でも自由に使える」という選択肢は誤りです。
ChatGPTと主要な生成AIモデルの動向
ここからは、モデルの名前と世代の対応です。
仕組みが分かることと、どの世代で何ができるようになったかが分かることは、別の作業でした。私も、仕組みの側は以前に取ったAI系資格の下地がそのまま効いたのに、世代と固有名詞だけは覚え直しています。新シラバスは「最新動向を継続的にキャッチアップするための情報収集力」も学習目標に挙げているので、名前を一言で説明できるところまで見ておく範囲だと思ってください。
GPTの世代と推論モデル
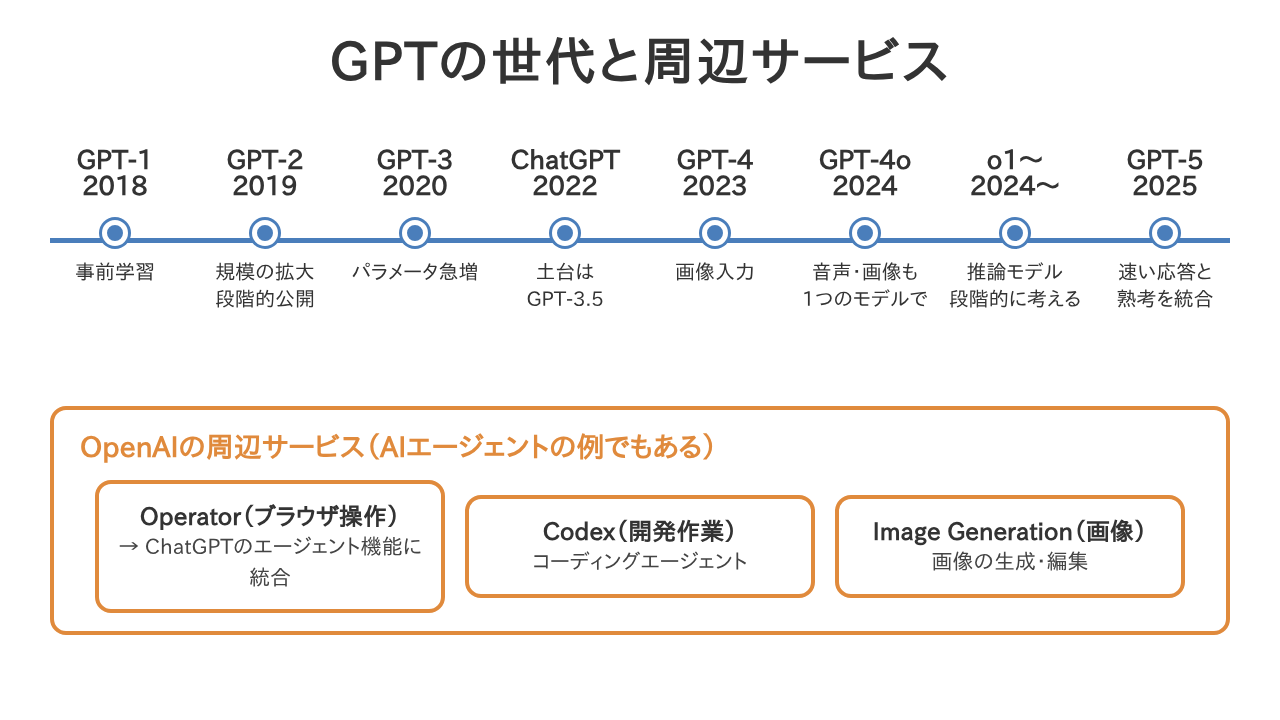
各世代で何ができるようになったかを1行で言えると、世代を聞く問題は取れます。
| 世代 | 発表年 | 問われる特徴 |
|---|---|---|
| GPT-1 | 2018年 | 大量の文章で事前学習を行ってから、用途ごとに調整するという進め方を示した |
| GPT-2 | 2019年 | 規模を拡大。悪用の懸念から段階的に公開した |
| GPT-3 | 2020年 | パラメータの数を大幅に増やし、いくつかの例を示すだけで多くの作業をこなせることを示した |
| GPT-3.5 | 2022年 | 2022年11月に公開されたChatGPTの土台になった世代 |
| GPT-4 | 2023年 | 画像を入力として受け取れるようになり、専門的な試験での正答率が大きく上がった |
| GPT-4o | 2024年 | 文章・音声・画像を1つのモデルでまとめて扱うマルチモーダル化を進めた |
| o1以降の推論モデル | 2024年〜 | 回答の前に内部で段階的に考えることで、数学やプログラミングの正答率を高めた |
| GPT-5 | 2025年 | すばやく答えるモデルと時間をかけて考えるモデルを1つの仕組みにまとめた |
シラバスには、さらに新しい世代の名前も並んでいます。モデルの入れ替わりが速い分野なので、受験する時点の公式情報で確認してください。
推論モデル(Reasoning Model)は、回答を出す前に、思考の連鎖(Chain-of-Thought)のような段階的な推論をモデルの内部で行うように学習されたモデルです。回答を出す段階(推論時)に多くの計算を使うことで、複雑な問題の正確さを高めます。その代わり、応答に時間や費用がかかることがあります。
Operator・Codex・Image Generation
OpenAIの周辺サービスは、役割で覚えます。
| 名前 | 役割 |
|---|---|
| Operator | Webブラウザの画面を見ながら操作し、予約や買い物などを代行するエージェント(その後ChatGPTのエージェント機能に統合) |
| Codex | コードの作成・修正・テストなど、ソフトウェア開発の作業を進めるコーディングエージェント |
| Image Generation | 文章で伝えた内容に沿った画像を作ったり、画像を編集したりする機能 |
OperatorとCodexは、第3章で扱うAIエージェントの具体例でもあります。
Gemini・Claude・Copilot
- Gemini:Googleが提供。文章に加えて画像や音声もまとめて扱えるマルチモーダルな生成AI
- Claude:Anthropicが提供。長い文書の読み取りやコーディングなどに使われる生成AI
- Copilot:Microsoftが提供。WordやExcelなどの中に組み込まれ、その場の作業を助ける形の生成AI
問題文では企業名か特徴のどちらかが手がかりになります。
各モダリティの生成AI
画像・音楽・音声・動画で何ができるか
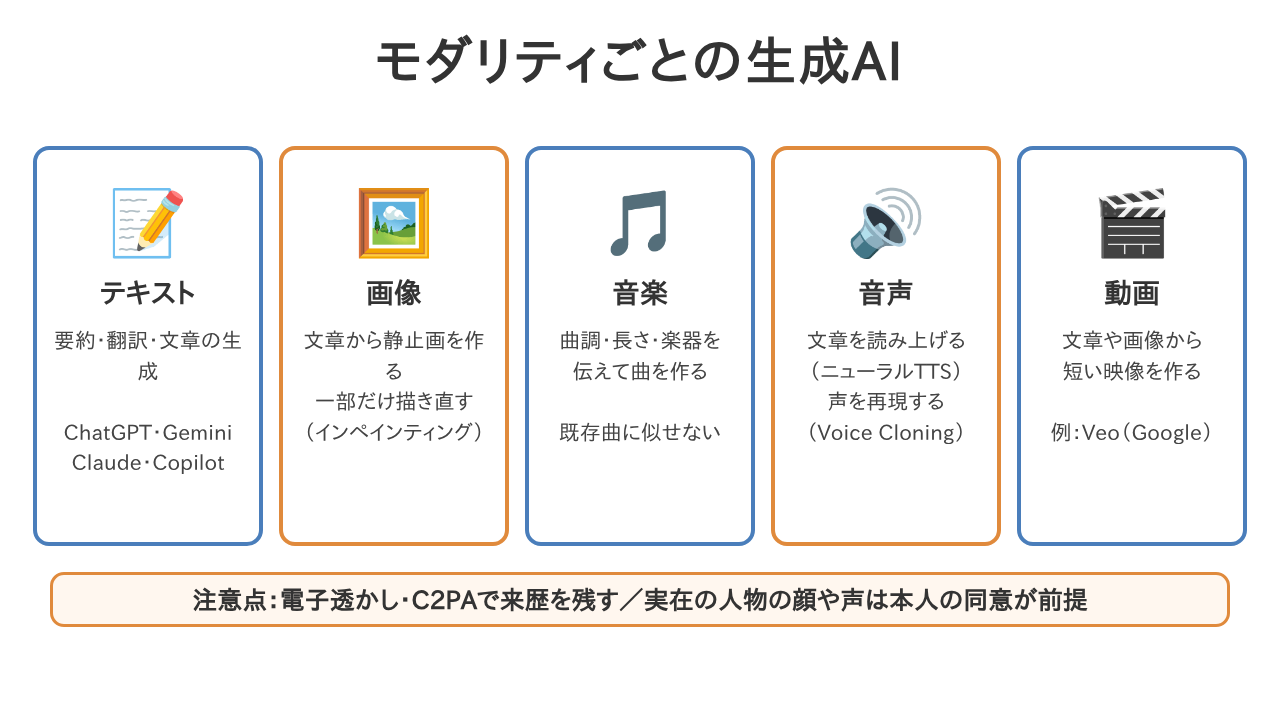
試験では、「文章を伝えると〜を作り出すAI」という説明から種類を選ぶ形と、使うときの注意点を選ぶ形の両方が出ます。
| 種類 | できること | 押さえる用語 |
|---|---|---|
| 画像生成AI | 文章の指示から静止画を作る。画像の一部だけを描き直す | インペインティング(指定した一部を描き直す) |
| 音楽生成AI | 曲調・長さ・楽器などの条件に合う曲を作る | 既存曲に似せない |
| 音声生成AI | 文章を自然な音声で読み上げる。特定の人の声を再現する | ニューラルTTS、Voice Cloning |
| 動画生成AI | 文章や画像から短い映像を作る | 映像の不自然さ・一貫性の確認 |
使うときの注意点:来歴と本人の同意
新シラバスでは、各モダリティの生成AIの「注意点」が学習目標に入っています。
- 電子透かし:生成したコンテンツに、人の目には見えにくい識別用の情報を埋め込む技術。AIで作られたかを後から確かめる手がかりになる
- 来歴情報とC2PA:コンテンツが誰によって、どのツールで作られ、どう編集されたかの記録(来歴情報)を、改ざんを検知できる形で付ける技術仕様がC2PA
- 本人の同意:実在の人物の顔や声を再現して使う場合は、本人の明確な同意が前提。同意のない利用は、肖像権・パブリシティ権の侵害や、本人が実際に言った・行ったかのような誤解(ディープフェイク)につながる
ディープフェイクによるなりすましや詐欺といった社会的なリスクは、第4章で扱います。
第2章の形式に合わせた例題3問
例題1:学習の段階を選ぶ
問題: 大規模言語モデルの学習で、モデルが出した複数の回答を人が比べて順位を付け、その評価を学んだ報酬モデルを使って、人が好ましいと感じる回答に近づけるようにモデルを調整する段階に該当するものを1つ選びなさい。
- 事前学習
- 指示チューニング
- RLHF
- ドメイン適応
答え:3
人の評価をもとにした報酬モデルを使って調整するのはRLHFです。事前学習は大量のテキストで次のトークンを予測する段階、指示チューニングは指示と望ましい回答の組で学習させる段階、ドメイン適応は特定分野のデータで追加学習させる取り組みです。
例題2:ハルシネーションの理由を選ぶ
問題: 大規模言語モデルでハルシネーションが起きる理由の説明として、最も適切なものを1つ選びなさい。
- 利用者をだます目的で、意図的に誤った情報を混ぜるように作られているから
- 文脈に続く確率の高いトークンを選んで文章を作るため、事実でなくても自然な文章を作れてしまうから
- コンピューターの計算に誤差が生じ、正しい単語が出力の直前に置き換わってしまうから
- Temperatureの値を低くすると、事実と異なる内容が必ず出力されるから
答え:2
LLMは「事実として正しいか」ではなく「もっともらしいか」でトークンを選んでいるため、知識が不確かな話題でも自然な文章を作ってしまいます。意図的な設計でも計算機の誤作動でもありません。Temperatureを低くすると、確率の高い語に寄って出力のばらつきは小さくなりますが、事実の正しさを保証するものではありません。
例題3:利用形態を選ぶ
問題: ある金融機関では、顧客情報を含む社内文書をLLMで要約したいと考えていますが、社内規程によりデータを社外のサーバーへ送信することは認められていません。この条件を満たす利用形態として、最も適切なものを1つ選びなさい。
- クラウド型LLMのAPIを、入力データを学習に使わない設定で利用する
- 一般向けの対話型AIに、顧客名だけを伏せ字にして入力する
- 利用条件を確認したうえで、オープンウェイトのモデルを自社の環境で動かす
- クラウド型LLMに、Few-Shotプロンプティングで要約の例を示して依頼する
答え:3
自社の環境でモデルを動かすオンプレミスLLMなら、データを社外へ送らずに処理できます。1・2・4はいずれもデータが社外のサーバーへ送られます。学習に使わない設定や伏せ字、プロンプトの工夫は、送信先そのものを変えません。
例題3問では物足りない人に向けて、第2章の練習問題6問を解説つきで無料公開しています。登録不要で、そのまま読めます。
本番形式の360問で仕上げる
生成AIパスポート 模擬試験360問(本番形式60問×6回)【2026年シラバス対応】
本番と同じ60問・60分の模擬試験を6回分、全360問。全問を2026年シラバスから書き下ろし、RAG・AIエージェント・MCP・AI新法といった追加範囲も含めています。正解・不正解を問わず全選択肢に解説をつけているので、間違えた理由がその場で分かります。
当ブログ限定クーポン:通常 2,600円 → 1,500円
よくある質問
Q. 旧シラバスの教材で第2章を勉強してしまいました。何を足せばよいですか?
足すのは、学習プロセス(事前学習・ファインチューニング・RLHF・報酬モデル・スケーリング則)、生成プロセス(トークン・埋め込み・確率分布・ハルシネーションの理由・コンテキストウィンドウ)、拡散モデル、LLMの利用形態(クラウド型・オンプレミス・オープンウェイト・データ主権)、推論モデル、各モダリティの注意点(電子透かし・C2PA・本人の同意)です。TemperatureとTop-p、LMとLLMは旧シラバスの第5章から移ってきました。
Q. 数式や計算方法は覚える必要がありますか?
ありません。Self-AttentionやRLHFの計算式は問われません。「何を使って、何を身につける段階か」「値を下げると出力がどう変わるか」が日本語で説明できれば足ります。
Q. 最新のモデル名は、試験までに増えませんか?
増えます。シラバスは毎年2月を基本に改訂され、モデルの名前は特に入れ替わりが速い部分です。仕組み(学習と生成の流れ)を先に覚えて、モデル名は受験する回のシラバスと公式情報で直前に確認するのが早いです。
Q. ローカルLLMとオープンウェイトは同じ意味ですか?
同じではありません。ローカルLLM(オンプレミスLLM)は「自社の環境で動かす」という利用形態の話、オープンウェイトは「重みが公開されている」というモデルの公開のされ方の話です。オープンウェイトのモデルをローカルで動かす、という組み合わせがよく使われます。
まとめ
- 新シラバスの第2章は、生成AIを「技術・学習・生成」の流れで捉える章
- Transformerは、Self-Attention(Query・Key・Value)で全体の関係を一度に計算し、並列処理と長距離依存に強い
- 拡散モデルは、ノイズを段階的に取り除く方法を学んで画像を作る。潜在拡散モデルは圧縮した空間で行う
- 学習は「事前学習→ファインチューニング(指示チューニング・ドメイン適応)→RLHF(報酬モデル)」の3段階
- 生成AIは次のトークンを確率で選んでいる。ハルシネーションも、Temperature・Top-pによる出力の変化も、ここから説明できる
- クラウド型は手軽だがデータは事業者側、オンプレミスはデータを管理できるが運用負担。オープンウェイトでも利用条件はライセンス次第
- 推論モデルは、回答の前に段階的に考える計算を多く使う
- 画像・音声・動画の生成AIは、電子透かし・C2PAによる来歴と、本人の同意が注意点
次の章は、新シラバスで独立した「AIエージェント」です。RAG、エージェントの仕組み、MCPやAgent Skillsによる外部連携、安全に使うための原則までを扱います。
▶ 生成AIパスポート 第3章「AIエージェント」の要点|RAG・MCP・Agent Skills・安全に使う原則
前の章はこちらです。
試験の概要と、勉強の順番は親記事に書いています。
▶ 生成AIパスポート試験の出題範囲を章別に学ぶ|5章まとめと学習ロードマップ
実際の試験の様子と、合格までにかけた勉強時間は、合格体験記にまとめています。
▶ 【合格体験記】生成AIパスポートの勉強方法|AIFとAI-900のあと、約10時間で合格した
この記事がお役に立ちましたら、コーヒー1杯分(300円)の応援をいただけると嬉しいです。いただいた支援は、より良い記事作成のための時間確保や情報収集に活用させていただきます。
システムエンジニア
AWSを中心としたクラウド案件に携わっています。
IoTシステムのバックエンド開発、Datadogを用いた監視開発など経験があります。
IT資格マニアでいろいろ取得しています。
AWS認定:SCS, ANS, AIP, SAP, DOP, SAA, DVA, SOA, CLF
Azure認定:AZ-104, AZ-300
ITIL Foundation
Oracle Master Bronze (DBA)
Oracle Master Silver (SQL)
Oracle Java Silver SE
■略歴
理系の大学院を卒業
IT企業に就職
AWSのシステム導入のプロジェクトを担当