当ブログにはPRを含みます。
生成AIパスポートの参考書は、1章目からニューロン、過学習、誤差逆伝播法、ノーフリーランチ定理と、知らない言葉が並びます。学習で最初に止まるのは、だいたいこの第1章です。
第1章「AIの基礎と歴史」は、生成AIの前の話です。2027年2月試験から適用される新しいシラバスでは、この章が大きく厚くなりました。機械学習の学び方に加えて、ニューラルネットワークが重みを調整して学ぶ仕組み、CNN・RNN・VAE・GANといった代表的なモデル、識別系AIと生成系AIの違いまでが、この章の範囲です。旧シラバスで第2章にあったモデルの話が、第1章に移ってきた形です。
言葉は多いので暗記に見えますが、出題を集めると、聞かれ方はかなり限られています。
シラバスの中項目に沿って、何が問われるかと、選択肢をどう減らすかを書きます。私は2026年6月の回に合格していて、この試験の問題集も作っています。出題を組み立てるときに使っている見方を、そのまま書いています。
シリーズの第1章です。試験の概要と、勉強の順番は親記事に書いています。
▶ 生成AIパスポート試験の出題範囲を章別に学ぶ|5章まとめと学習ロードマップ
第1章で問われるのは「AIの土台となる考え方と技術のつながり」
新シラバスの第1章は、4つの中項目に分かれています。出題の中心は、3つ目の「ニューラルネットワーク」です。ここに学習の仕組み、過学習、代表的なモデルがまとめて入っています。
中項目ごとの出題のされ方
| 中項目 | 主な用語 | 問われ方 |
|---|---|---|
| AIの基本的な仕組み | AI、ルールベース、機械学習、ディープラーニング | ルールベースの限界と機械学習の違い/3つの言葉の関係 |
| 機械学習 | 教師あり学習(分類・回帰)、教師なし学習(クラスタリング・次元削減)、強化学習(報酬・価値・方策)、半教師あり学習、正解率、ノーフリーランチ定理 | 場面を読んで学び方を選ぶ/用語の定義を選ぶ |
| ニューラルネットワーク | 入力層・隠れ層・出力層、重み、活性化関数、損失関数、誤差逆伝播法、勾配降下法、過学習、汎化、アーリーストッピング、正則化、ドロップアウト、転移学習、ファインチューニング、CNN、RNN、LSTM、勾配消失問題、VAE、GAN、識別系AIと生成系AI | 学習の流れの中の役割を選ぶ/モデルの説明を選ぶ |
| AIの歴史 | ダートマス会議、第一次〜第三次AIブーム(探索・推論、エキスパートシステム、ビッグデータ)、AIの冬、拡散モデル、Transformer、LLM、シンギュラリティ | 技術とブームの対応/歴史の順序 |
旧シラバスにあった「弱いAIと強いAI」「特徴量」「AI効果」「2045年問題」などは、新シラバスの用語から外れました。その代わりに、学習の仕組みとモデルの説明が大幅に増えています。
第1章を解く軸は3つ
第1章の問題は、次の3つの見方のどれかで、ほとんど選べます。
1つ目は、正解のラベルがあるかどうかです。機械学習の手法を選ばせる問題は、問題文に「正解を与えて」「分類を付けたうえで」とあれば教師あり学習、「正解を与えず」「自ら見つけ出す」とあれば教師なし学習、「報酬が高くなるように」とあれば強化学習です。
2つ目は、学習の流れのどこの話かです。ニューラルネットワークの用語は、「予測を出す(活性化関数)→ずれを測る(損失関数)→ずれの原因をさかのぼる(誤差逆伝播法)→重みを直す(勾配降下法)」という流れのどこにあるかで分けられます。
3つ目は、そのモデルが何を入力して何を出すのかです。CNNは画像から特徴を取り出す、RNNは順番のあるデータを前から処理する、VAEは圧縮して作り直す、GANは作る役と見破る役を競わせる。この一言が言えれば、モデルの説明を選ぶ問題は取れます。
AIの基本的な仕組み:ルールベースと機械学習
最初の中項目は、AIに知能をもたらす2つの仕組みの対比です。
ルールベースと機械学習の違いは「誰が規則を作るか」
ルールベースは、「もし〜ならば、〜する」という条件と動作の対応を、人間があらかじめ書き込んでおく方式です。書いたとおりにしか動かない代わりに、なぜその判断になったかは完全に説明できます。
機械学習は、人間が規則を書く代わりに、大量のデータから規則性をソフトウェア自身に見つけさせる方式です。データが変われば学習し直すことで判断も変わります。
ルールベースの限界は、例外や想定外の状況まで含めて、ルールを人が書き尽くすのが難しい点にありました。迷惑メールの判定を、「この単語があれば迷惑メール」というルールだけで作ろうとすると、言い回しを少し変えただけのメールをすり抜けさせてしまいます。機械学習は、迷惑メールと通常のメールの例を大量に学ばせて、見分け方そのものを身につけさせることで、この限界を補いました。
AI・機械学習・ディープラーニングの関係
この3つの言葉は、入れ子の関係です。
- AI:人間の知的なふるまいを、コンピューターで実現しようとする技術や研究分野の総称
- 機械学習:AIを実現する手法の一つ。データから規則性を学ぶ
- ディープラーニング(深層学習):機械学習の手法の一つ。何層にも重ねたニューラルネットワークを使う
「AI ⊃ 機械学習 ⊃ ディープラーニング」という関係を逆にした選択肢(ディープラーニングの中に機械学習がある、など)がよく混ざるので、広さの順番で覚えておきます。
機械学習の学び方を1枚で見分ける
4つの学び方は「正解ラベルの与え方」で分かれる
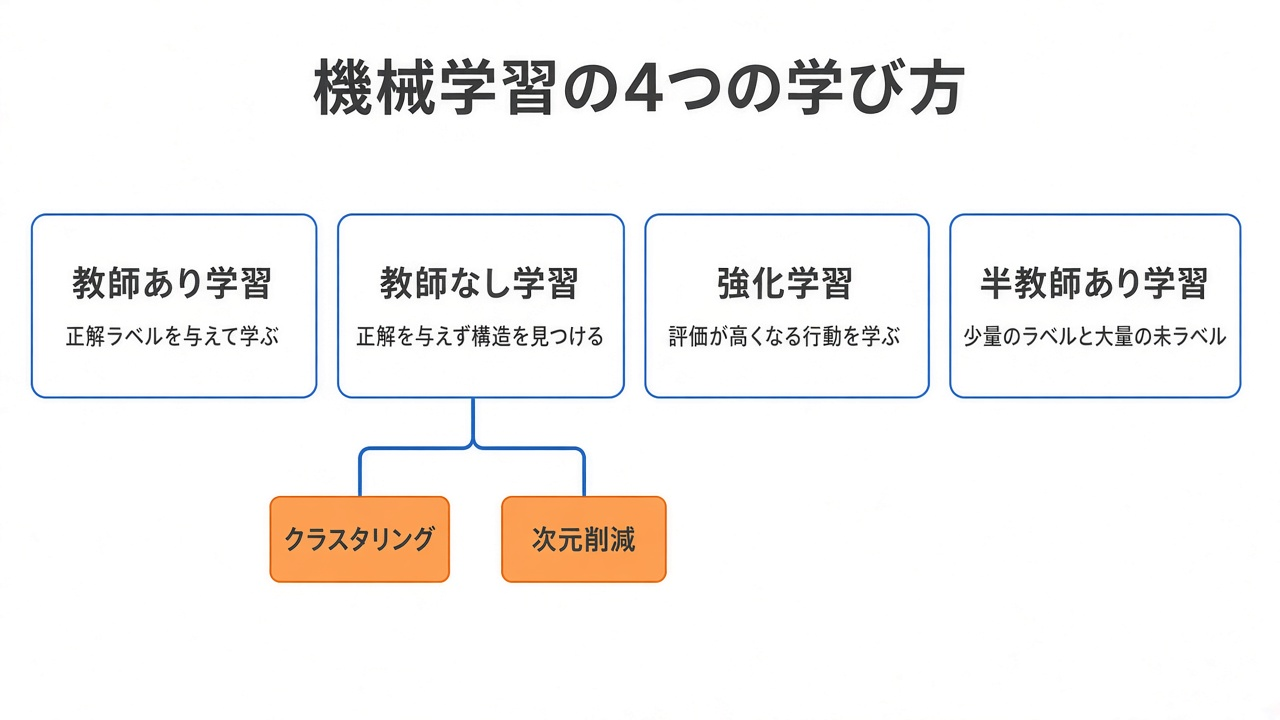
試験では、図の左上にある「正解ラベルがあるか」を読み取れれば、ほとんどの問題で選択肢は2つまで絞れます。
教師あり学習は、入力データと正解(ラベル)を組にした教師データで学ばせる方法です。出力の種類で2つに分かれます。
- 分類:決まったカテゴリのどれに当たるかを答える。答えが2つなら二値分類(迷惑メールかどうか)、3つ以上なら多値分類(犬・猫・鳥のどれか)
- 回帰:売上や気温のような連続した数値を答える
教師なし学習は、正解のラベルを与えず、データの中にあるまとまりや構造そのものを見つけさせる方法です。下に2つの手法があります。
- クラスタリング:特徴が近いデータを同じかたまり(クラスタ)にまとめる。顧客をいくつかのグループに分ける、といった使い方
- 次元削減:多くの項目で表されたデータを、情報をなるべく保ったまま少ない項目で表し直す。100項目のアンケートを数個の軸にまとめ直す、といった使い方
「グループにまとめる」のがクラスタリング、「項目の数を減らす」のが次元削減です。
強化学習は、行動の結果として得られる報酬が大きくなるように、試行錯誤しながら行動の選び方を学ぶ方法です。新シラバスでは、強化学習の用語が3つ加わりました。
- 報酬:行動した結果、環境から受け取る評価の値(その場の点数)
- 価値:ある状態や行動から先、将来にわたって得られそうな報酬の見込み
- 方策:ある状態のとき、どの行動を選ぶかを決めるルール
将棋にたとえると、駒を取ったときの得点が報酬、局面の有利さの見積もりが価値、次の一手を決める指し方の方針が方策です。
半教師あり学習は、正解ラベルの付いた少量のデータと、付いていない大量のデータを組み合わせて学ばせる方法です。「大量に集めた画像のうち、人手で分類を付けられたのはごく一部」という前置きが出てきたらこれです。
正解率とノーフリーランチ定理
正解率は、分類モデルの予測のうち正しかったものの割合です。分かりやすい指標ですが、片方のクラスが極端に少ないデータでは注意が必要です。1,000件中10件しか不正利用がないデータなら、すべてを「正常」と答えるだけで正解率は99%になりますが、不正は1件も見つけられていません。
ノーフリーランチ定理は、「あらゆる問題に対して、ほかのどの手法よりも常に優れた性能を出す万能な手法は存在しない」という考え方です。「どんな課題にも使える最強のアルゴリズムがある」という趣旨の選択肢は、この定理の内容と逆なので誤りです。
ニューラルネットワークが「学ぶ」仕組み
ここからが、新シラバスで大きく増えた範囲です。用語は多く見えますが、「脳の言葉とコンピューターの言葉の対応」と「学習の流れ」の2つに分けると、つながって見えます。
脳の言葉とコンピューターの言葉の対応
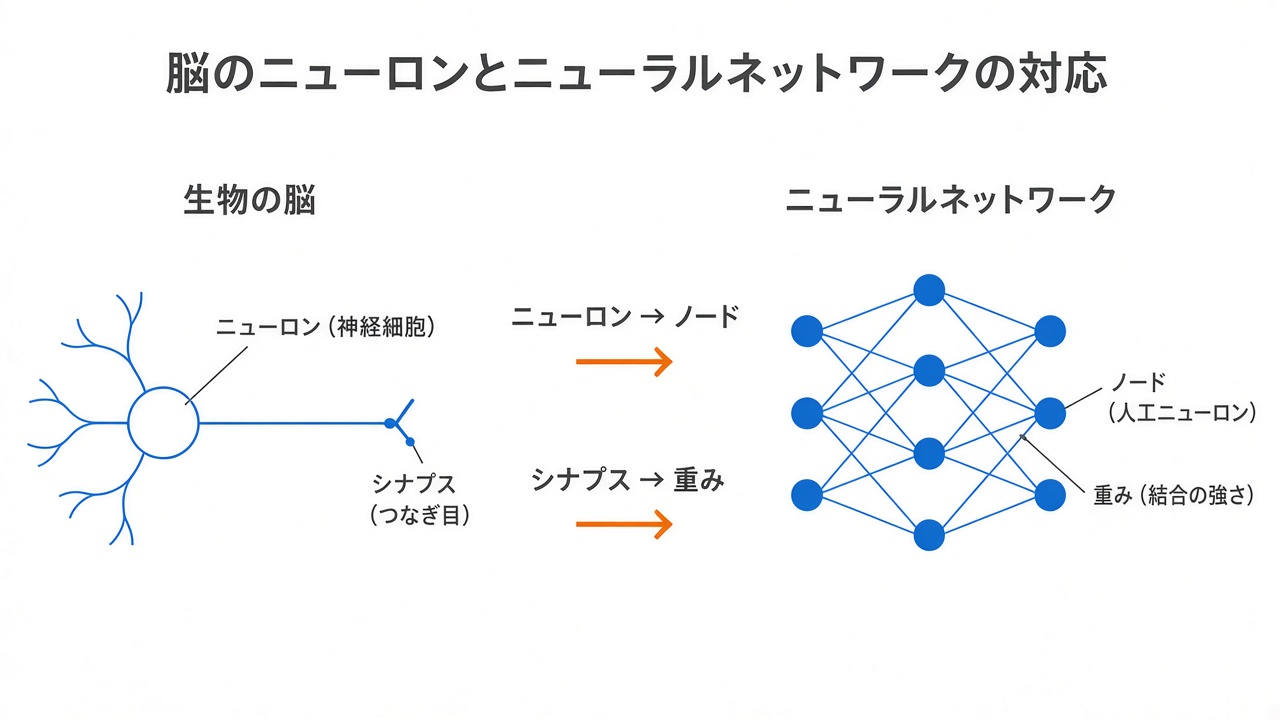
ニューロンがノードに、シナプス(つながりとその強さ)が重みに対応します。
| 脳の言葉 | ニューラルネットワークの言葉 | 役割 |
|---|---|---|
| ニューロン(神経細胞) | 人工ニューロン(ノード) | 受け取った値をまとめて次へ渡す最小の単位 |
| シナプス(細胞どうしのつなぎ目) | 重み(結合の強さ) | 次へ伝える信号をどれだけ強めるか弱めるかを表す数値 |
| 脳全体のネットワーク | ニューラルネットワーク | ノードを層状につなぎ、つながりの強さを学習で調整する仕組み |
入力層・隠れ層・出力層と活性化関数
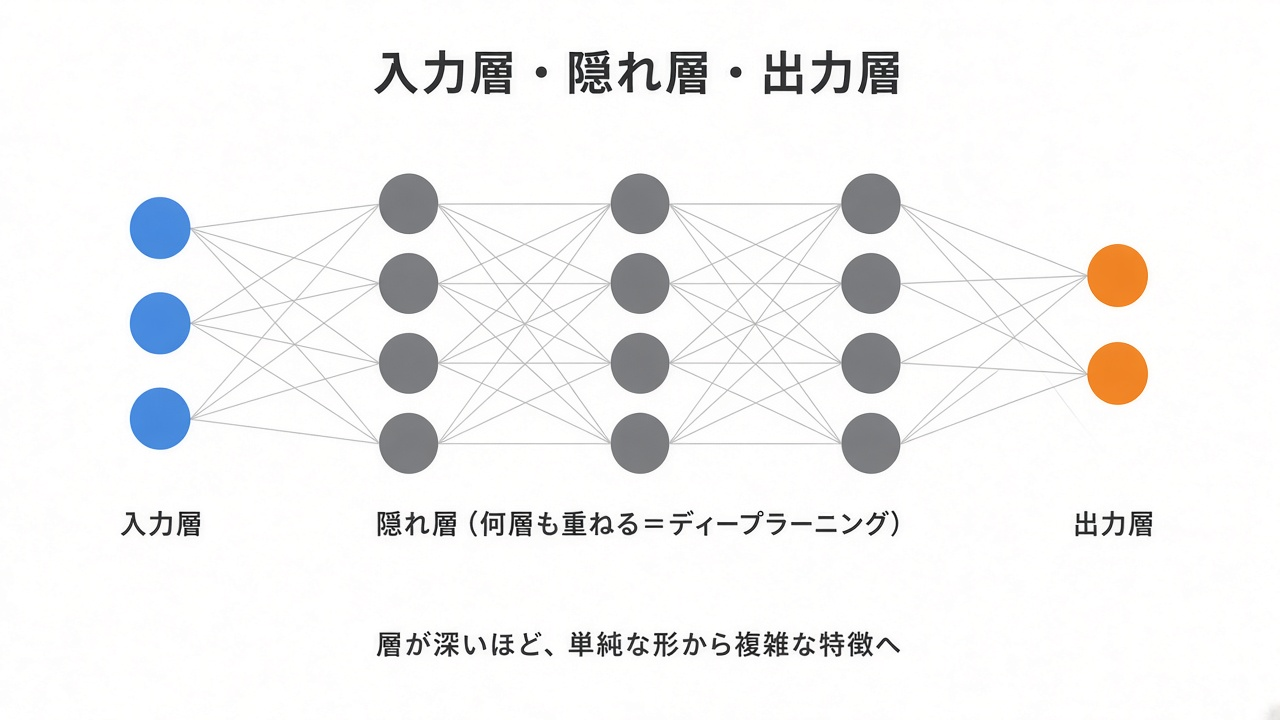
データを受け取るのが入力層、結果を出すのが出力層、その間が隠れ層です。隠れ層を何層も重ねたものがディープラーニング(深層学習)です。層が深くなるほど、単純な形から複雑な特徴へ、段階的に組み立てられます。
- 入力層:画素の値などのデータを受け取る
- 隠れ層(中間層):受け取った値を変換しながら、特徴を段階的に組み立てる
- 出力層:分類の結果や予測の値など、最終的な答えを出す
各ノードは、前の層から受け取った値に重みを掛けて足し合わせ、その結果を活性化関数に通して次の層へ渡します。活性化関数が非線形の変換を担うことで、層を重ねたネットワークが複雑な関係を表せるようになります。もし活性化関数がなければ、層をいくら重ねても全体は1本の直線的な計算と同じになってしまいます。
学習の流れ:予測→ずれを測る→さかのぼる→直す
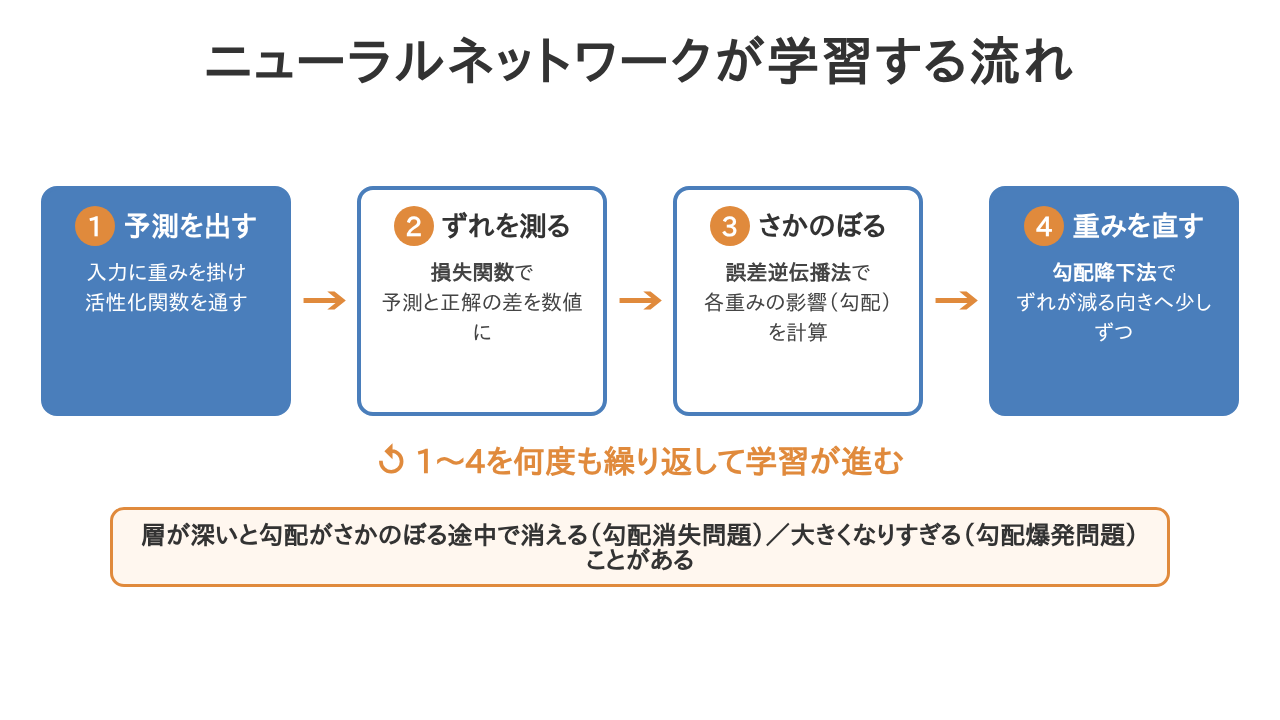
予測を出し、損失関数で正解とのずれを測り、誤差逆伝播法でずれの原因を出力側から入力側へさかのぼって求め、勾配降下法で重みを少しずつ直します。これを何度も繰り返して学習が進みます。
新シラバスで加わった4つの用語は、この1周のどこを担うかで分けます。
| 用語 | 学習の流れの中の役割 | ひとことで |
|---|---|---|
| 損失関数 | 予測と正解のずれ(損失)を1つの数値で表す | 採点基準 |
| 誤差逆伝播法(バックプロパゲーション) | ずれを出力層から入力層へさかのぼり、各重みがずれにどれだけ影響したか(勾配)を計算する | 原因の特定 |
| 勾配降下法 | 勾配をもとに、損失が小さくなる方向へ重みを少しずつ動かす | 直し方 |
| 活性化関数 | 各ノードの出力を作る非線形の変換 | 計算の通り道 |
勾配降下法は、霧の中で足元の傾きだけを頼りに、低いほうへ一歩ずつ山を下りていくイメージです。誤差逆伝播法で「どちらに傾いているか」を計算し、勾配降下法でその方向に一歩進む、という役割分担で覚えると取り違えません。
層が非常に深いと、さかのぼる途中で勾配がほとんど0になって入力層に近い層の学習が進まなくなる勾配消失問題や、逆に勾配が極端に大きくなって学習が不安定になる勾配爆発問題が起こります。この2つは名前の向き(小さくなりすぎる/大きくなりすぎる)で区別します。
過学習と、その対策
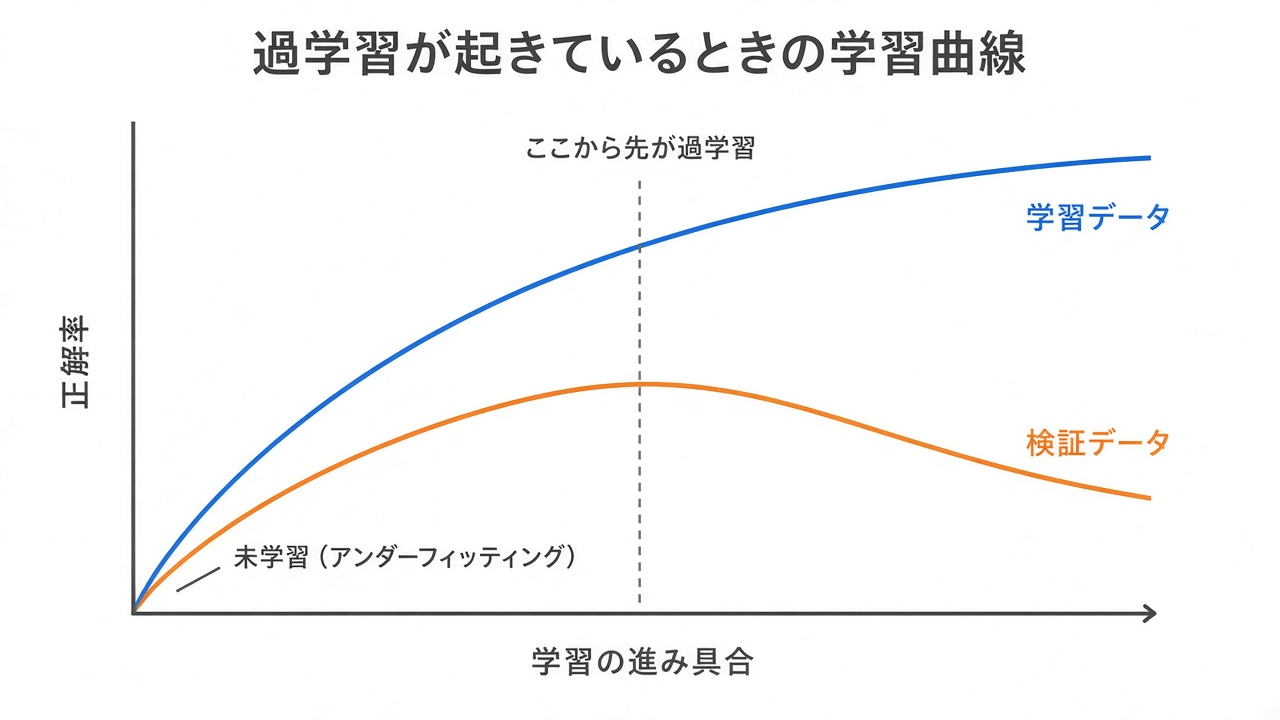
横軸が学習の進み具合、縦軸が正解率です。学習データでの成績(青)は上がり続けるのに、検証用データでの成績(橙)は途中から下がり始めます。この分かれ目から先が過学習です。左側の、どちらも低いままの領域は未学習(アンダーフィッティング)です。
過学習(オーバーフィッティング)は、モデルが学習用データの細かなクセまで覚え込んでしまい、新しいデータに対する予測の精度が下がってしまう状態です。反対に、学習に使っていない新しいデータでも正しく予測できる力を汎化(汎化性能)といいます。機械学習の目的は、汎化性能の高いモデルを作ることです。
過学習を避ける手法として問われるのは、次の3つです。
- アーリーストッピング:検証用データでの成績が悪化し始めた時点で学習を打ち切る
- 正則化:重みの大きさに応じた罰(ペナルティ)を損失に加え、極端な重みが付きにくくする
- ドロップアウト:学習のたびにノードの一部をランダムに無効にし、特定のノードの組み合わせに頼りきるのを防ぐ
一方、転移学習は、ある課題のために学習させたモデルの知識を、関連する別の課題に流用する手法です。少ないデータでも実用になる精度を目指せる利点がありますが、過学習を防ぐこと自体を目的とした技術ではありません。転移学習の代表的なやり方が、学習済みモデルの重みを新しいデータで追加学習して調整するファインチューニングです。「過学習を避けるための手法を2つ選びなさい」という複数選択で転移学習を選ばせないのが作問側の狙いなので、ここは意識して分けておいてください。
代表的なモデル:何を入力して、何を出すか
旧シラバスでは第2章にあったモデルの話が、新シラバスでは第1章に移りました。ここでも「何を入力して何を出すか」の一言で分けます。
CNN:画像から特徴を取り出す
CNN(畳み込みニューラルネットワーク)は、画像の特徴を取り出すのが得意なネットワークです。中心にあるのは畳み込みという演算で、小さなフィルターを画像の上でずらしながら当て、近くの要素どうしのつながりを捉えて特徴を取り出します。これを何層も重ねると、浅い層では線や角のような単純な特徴を、深い層ではそれらを組み合わせた複雑な特徴を取り出せるようになります。
画像に写っているものを判別するコンピュータビジョンの分野で、ディープラーニングが従来の手法を大きく上回る精度を出したのが、第三次AIブームを本格化させるきっかけになりました。
RNNとLSTM:順番のあるデータを扱う
シーケンスデータとは、文章や株価の推移のように、順序に意味があるデータです。
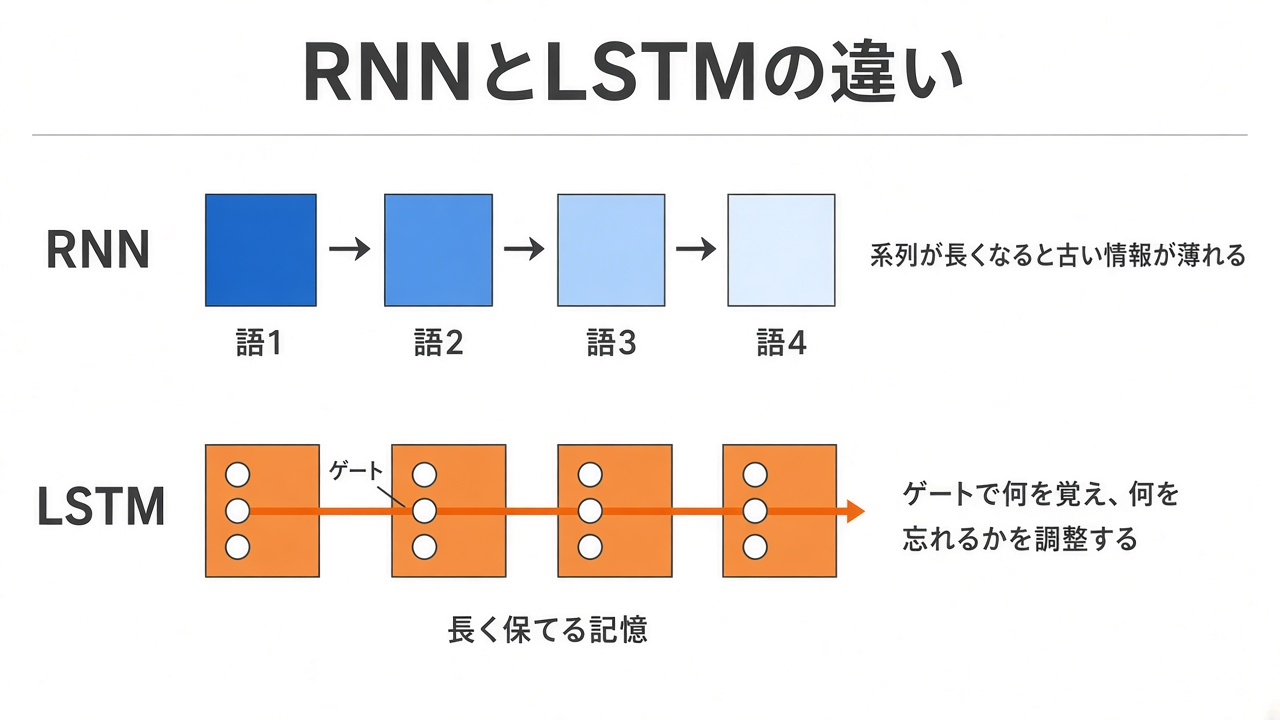
RNNは前の時点の結果を次へ引き継ぎますが、系列が長くなると古い情報が薄れていきます。LSTMはゲートで「何を覚え、何を忘れ、何を出すか」を調整し、長い系列でも情報を保てるようにしました。
RNN(再帰型ニューラルネットワーク)は、前の時点の計算結果を次の時点に引き継ぎながら、シーケンスデータを順番に処理していくモデルです。ただし、系列が長くなると、さかのぼるうちに勾配が消えてしまい(勾配消失問題)、古い情報を保てなくなるという弱点がありました。
LSTMは、RNNにゲートという仕組みを加え、何を覚えて何を忘れるかを調整できるようにしたモデルです。「RNNを改良し、ゲートという仕組みを加えたモデル」という説明が出たらLSTMです。
なお、RNNの「1語ずつ順番に処理する」という弱点を乗り越えたのが、第2章で扱うTransformerのAttentionです。
VAE:圧縮して、作り直す
VAE(変分オートエンコーダ)は、データを圧縮してから作り直すことで、新しいデータを生成する手法です。
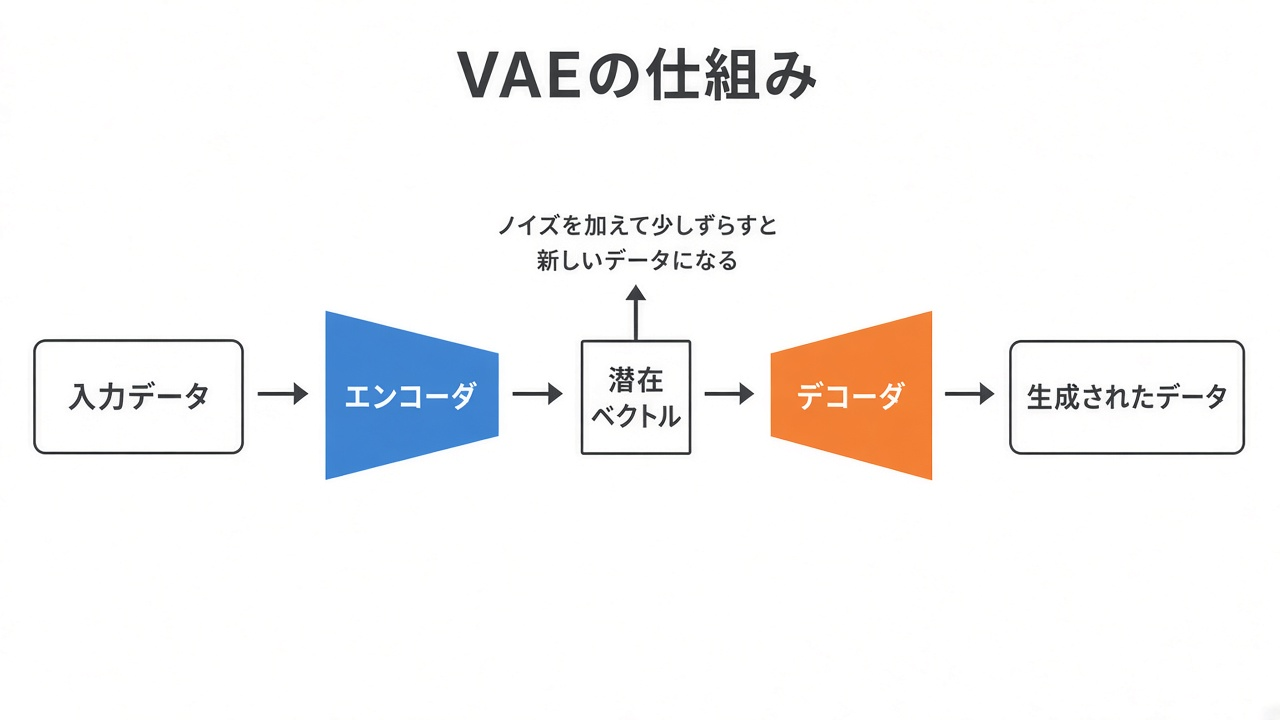
エンコーダが入力を潜在ベクトルに圧縮し、デコーダがそこから元に近いデータを作り直します。潜在ベクトルにノイズを加えて少しずらすと、元のデータに似た新しいデータが生まれます。
- エンコーダ:入力されたデータを、少ない数値の並びに圧縮する側
- 潜在ベクトル:エンコーダが入力を圧縮して表した、元のデータより少ない数の値の並び
- デコーダ:潜在ベクトルから、元に近いデータを復元する側
GAN:作る役と、見破る役
GAN(敵対的生成ネットワーク)は、2つのネットワークを競わせることでデータの質を高める手法です。
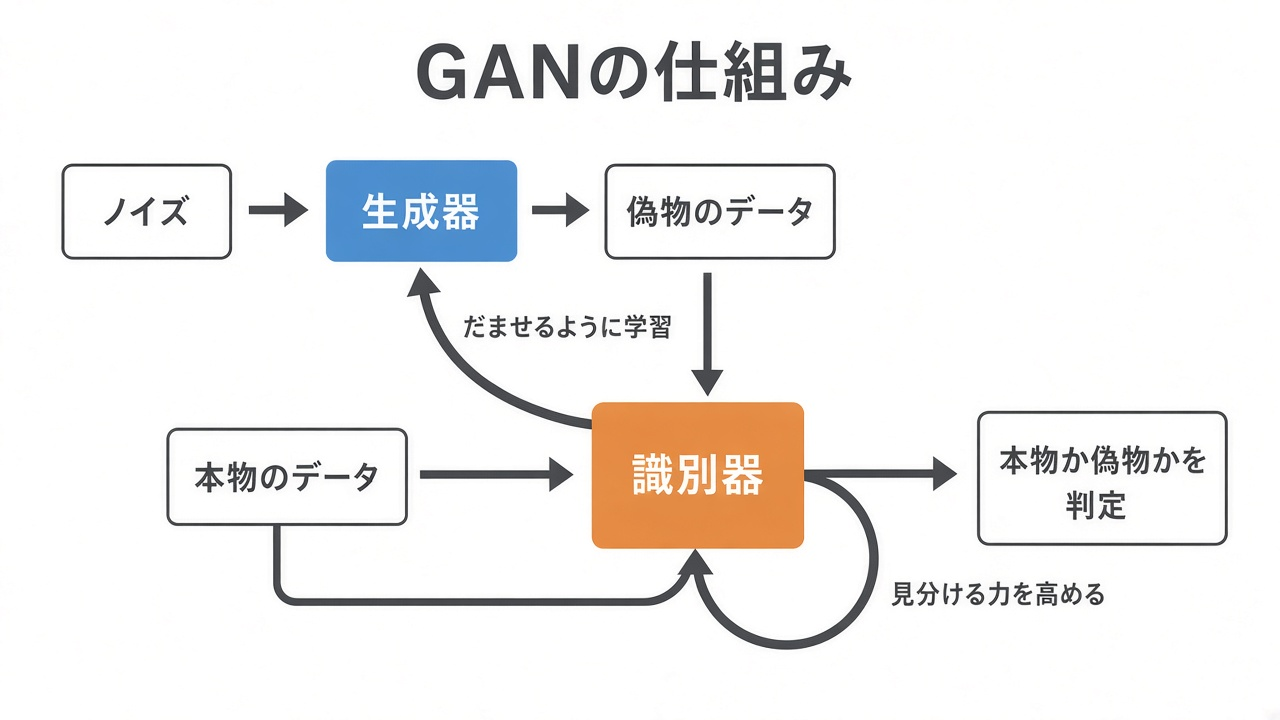
生成器はランダムなノイズから偽物を作り、識別器は本物か偽物かを見分けます。識別器が賢くなるほど、生成器はより精巧な偽物を作る必要があり、これを繰り返すうちに本物と区別できないデータが生まれます。
- 生成器(Generator):ランダムなノイズを入力として受け取り、本物に似せたデータを作り出す
- 識別器(Discriminator):渡されたデータが本物か、生成器が作ったものかを見分ける
エンコーダ、デコーダ、潜在ベクトルが出てきたらVAE。生成器、識別器、ノイズが出てきたらGANです。用語がきれいに分かれているので、1語でも拾えれば決まります。
識別系AIと生成系AI
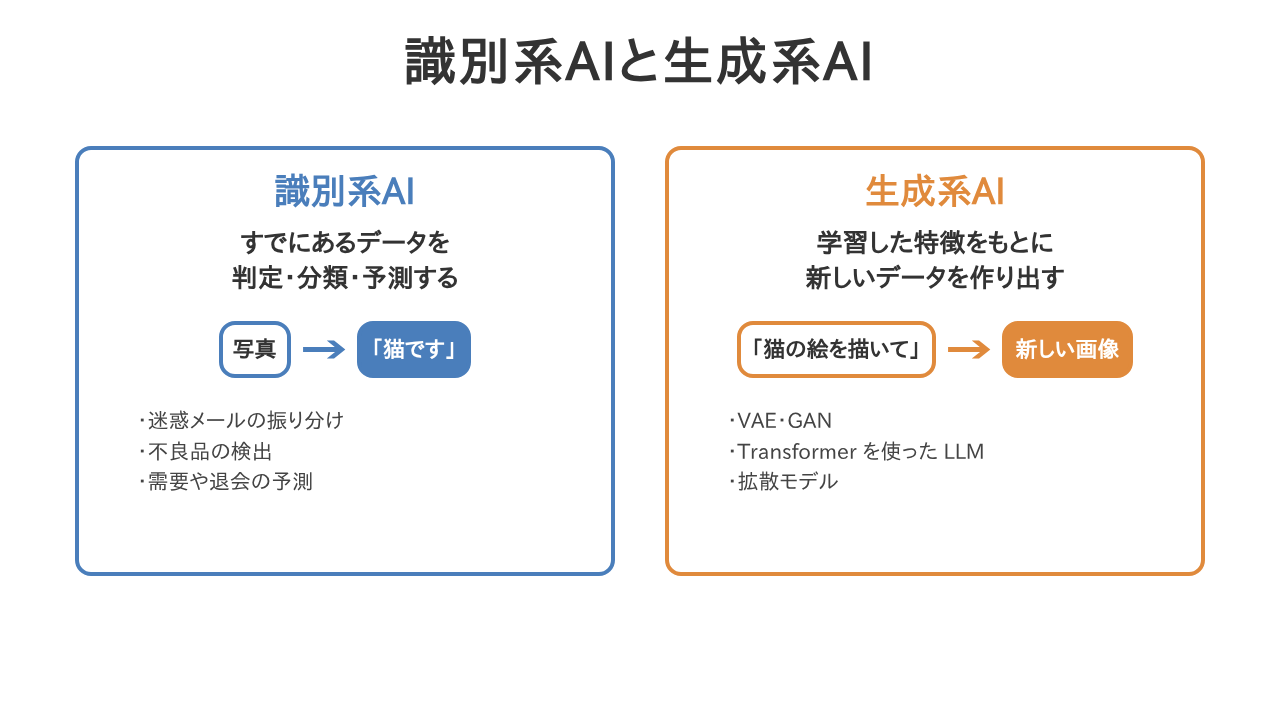
識別系AIは、すでにあるデータを判定・分類・予測します。生成系AIは、学習したデータの特徴をもとに、新しいデータを作り出します。
ここまでのモデルは、大きく2つの系統に分けられます。
- 識別系AI:入力されたデータが何に当たるかを判定・分類・予測する。画像の判別、迷惑メールの振り分け、需要の予測など
- 生成系AI:学習したデータの特徴をもとに、新しい文章・画像・音声などを作り出す。VAE、GAN、そして第2章で扱うTransformerを使った大規模言語モデルや拡散モデル
見分けるポイントは「すでにあるデータを判定しているか、新しいデータを作り出しているか」です。数値の予測(退会の確率など)を出していても、新しいコンテンツを作っていなければ識別系です。
生成系AIの技術は、本物と見分けにくい偽の映像や音声(ディープフェイク)にも使われます。その社会的なリスクは第4章で扱います。
AIの歴史:ダートマス会議から生成AIまで
最後の中項目は、AIの歴史です。新シラバスでは、第三次AIブームの先に、ディープラーニングから生成AIへの流れまでが加わりました。
ここは、私が実際に落としたところでもあります。2026年6月の回を受けたとき、章別の正答率で100%を切ったのは第1章だけ(87.5%)でした。第2章以降が残ったのは、業務で使っている生成AIの話と地続きだったからです。逆にAIの歴史やシンギュラリティは、仕事で使う場面がなく、正直なところ興味も持てなかったぶん、覚えたつもりで抜けていました。
分量が少ない範囲ほど「後でまとめて」と後回しにしがちですが、興味を持てない範囲は、理解して納得しようとしても残りません。技術とブームの対応だけを、カードのように短時間で何度も回すほうが残ります。この節は、そういう扱いをする前提で読んでください。
1956年・ダートマス会議
「人工知能(Artificial Intelligence)」という言葉が研究分野の名として掲げられたのが、1956年にアメリカで開かれたダートマス会議です。この言葉を提案したのがジョン・マッカーシーです。不正解の選択肢には、チューリングテスト(1950年)、IBMのワトソン、人工知能学会の設立などが並びますが、どれも「人工知能という言葉そのものの由来」ではありません。
3つのブームとAIの冬
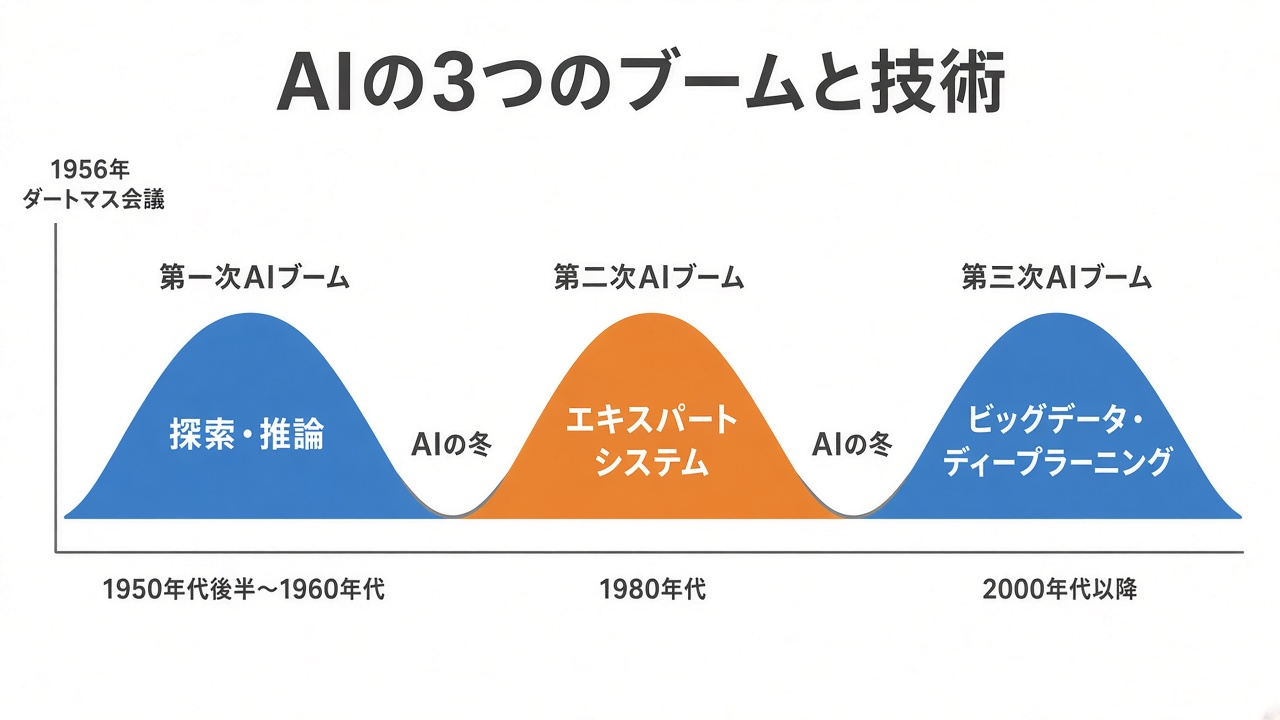
第一次が探索と推論、第二次がエキスパートシステム、第三次がビッグデータとディープラーニングです。あいだに冬の時期があります。試験では「この技術はどのブームか」がそのまま聞かれます。
第一次AIブーム(1950年代後半〜1960年代)の中心は探索と推論です。探索は、迷路やパズルの答えにたどり着くために、取り得る手を順に調べて道筋を見つける手法。推論は、分かっている事実と決まりを組み合わせて新しい結論を導く手法です。決められたルールの中の問題は解けても、現実の複雑な問題には歯が立たず、ブームは終わりました。
第二次AIブーム(1980年代)の中心はエキスパートシステムです。専門家の知識を「もし〜ならば〜」というルールとして書き込んだ知識ベースをたどって結論を出す仕組みで、ルールベースの代表例です。医療診断などで実用化されましたが、例外まで含めた専門家の知識を、ルールとして書き出しきれなかったため、広くは普及しませんでした。
AIの冬は、期待に比べて実用上の成果が伸びず、研究への予算や関心が大きく減った時期を指す言葉です。第一次ブームの後と第二次ブームの後に訪れました。
第三次AIブーム(2000年代以降)を支えたのは、インターネットや機器の普及で大量に集まるようになったビッグデータと、それを使った機械学習、そしてディープラーニングの実用化です。2012年ごろ、画像認識でディープラーニングが従来の手法を大きく上回ったことが、ブームを本格化させました。
ディープラーニングから生成AIへ
第三次ブームの先の流れは、次の順番で見ておきます。
- ディープラーニングによる画像認識・音声認識の精度向上(2010年代前半)
- Transformerの発表(2017年)。並列処理に向いた構造で、大規模な学習が可能に
- LLM(大規模言語モデル)と拡散モデル(Diffusion Model)の発展。高品質な文章と画像の生成が可能に
- ChatGPTの公開(2022年11月)で、生成AIが一般に広く普及
「ChatGPTはTransformerを土台にしたモデルを使っている」ことを覚えておけば、Transformerより前にChatGPTを置いた並べ方は誤りだと判断できます。
シンギュラリティと今後の展望
シンギュラリティ(技術的特異点)は、AIが人間の知能を超え、技術の進歩が加速して、それ以降の社会の変化を人間が予測できなくなるとされる転換点です。到来するかどうかや時期については、研究者の間でも意見が分かれています。特定のタスク(画像認識など)でAIが人間を上回ったことを指す言葉ではない点に注意してください。
旧シラバスにあった「AI効果」という言葉は、新シラバスの用語からは外れました。ただ、考え方としては今も有効です。私は勤務先で、全社員に配られた生成AIの使い方を指導する役回りをしています。そこでよく話すのが、「昔は暗算が速いことに価値がありましたが、今は電卓があります。足が速いことにも価値がありましたが、今は車や新幹線があります」というたとえです。新しい道具は、使われ始めた頃はすごい技術として扱われ、行き渡ると道具として当たり前になります。
第1章の形式に合わせた例題3問
ここまでの内容が使える形になっているか、本番と同じ四肢択一の形で確認します。
例題1:場面から学習手法を選ぶ
問題: あるコールセンターで、過去の通話記録のうち人手で「解決済み」「要折り返し」の分類を付けられたのは全体の5%だけでした。残りの95%には分類が付いていません。この両方を使ってモデルを学習させる手法として、最も適切なものを1つ選びなさい。
- 教師あり学習
- 教師なし学習
- 半教師あり学習
- 強化学習
答え:3
正解のラベルが付いた少量のデータと、付いていない大量のデータを組み合わせて学習させるのが半教師あり学習です。教師あり学習ならすべてにラベルが必要で、教師なし学習ならラベルを使いません。強化学習は行動への報酬をもとに学ぶ枠組みで、この場面には当てはまりません。
例題2:学習の流れの中の役割を選ぶ
問題: ニューラルネットワークの学習で、出力層で求めた予測と正解のずれを、出力層の側から入力層の側へさかのぼって伝え、各重みがずれにどれだけ影響したかを計算する方法に該当するものを1つ選びなさい。
- 勾配降下法
- 誤差逆伝播法
- 活性化関数
- ドロップアウト
答え:2
ずれを出力側から入力側へさかのぼって、各重みの影響(勾配)を計算するのが誤差逆伝播法です。勾配降下法は、その勾配を使って重みを更新する方法で、組み合わせて使われますが役割が違います。活性化関数は各ノードの出力を作る関数、ドロップアウトは過学習の対策です。
例題3:モデルを部品名で切る
問題: ランダムな数値の並びを入力として受け取り、本物に似せたデータを作り出すネットワークと、渡されたデータが本物かどうかを見分けるネットワークを組み合わせた生成手法に該当するものを1つ選びなさい。
- VAE(変分オートエンコーダ)
- GAN(敵対的生成ネットワーク)
- CNN(畳み込みニューラルネットワーク)
- LSTM
答え:2
「作り出すネットワーク(生成器)」と「見分けるネットワーク(識別器)」の組み合わせはGANです。VAEは、入力を潜在ベクトルに圧縮するエンコーダと、そこから復元するデコーダの組み合わせです。CNNは画像から特徴を取り出すネットワーク、LSTMはRNNにゲートを加えたモデルで、どちらも2つのネットワークを競わせる構造ではありません。
例題3問では物足りない人に向けて、第1章の練習問題6問を解説つきで無料公開しています。登録不要で、そのまま読めます。
本番形式の360問で仕上げる
生成AIパスポート 模擬試験360問(本番形式60問×6回)【2026年シラバス対応】
本番と同じ60問・60分の模擬試験を6回分、全360問。全問を2026年シラバスから書き下ろし、RAG・AIエージェント・MCP・AI新法といった追加範囲も含めています。正解・不正解を問わず全選択肢に解説をつけているので、間違えた理由がその場で分かります。
当ブログ限定クーポン:通常 2,600円 → 1,500円
よくある質問
Q. 第1章は生成AIの話が出てこないので、飛ばしてもよいですか?
飛ばさないほうがよいです。第2章のTransformer、大規模言語モデル、拡散モデルは、どれもニューラルネットワークの応用です。ノード、重み、損失関数が分かっていないと、第2章は丸暗記になります。
Q. 誤差逆伝播法や勾配降下法の数式は覚える必要がありますか?
ありません。生成AIパスポートは四肢択一式で、数式を問う出題はありません。「誤差逆伝播法はずれをさかのぼって勾配を計算する」「勾配降下法は勾配をもとに重みを少しずつ直す」という日本語の説明が選べれば十分です。
Q. 旧シラバスの教材で第1章を勉強してしまいました。何を足せばよいですか?
足すのは3つです。1つ目は学習の仕組み(活性化関数・損失関数・誤差逆伝播法・勾配降下法・勾配消失問題)、2つ目は旧第2章から移ってきたCNN・RNN・LSTM・VAE・GANと識別系/生成系の違い、3つ目は強化学習の報酬・価値・方策と、分類・回帰・正解率です。逆に、弱いAIと強いAI、特徴量、AI効果、2045年問題は新シラバスの用語から外れました。
Q. 人名や年号はどこまで覚えればよいですか?
新シラバスの第1章で覚えておきたいのは、ダートマス会議(1956年)とジョン・マッカーシー、Transformerの発表(2017年)、ChatGPTの公開(2022年)です。歴史は年号よりも、「どの技術がどのブームか」「どの順番で発展したか」が問われます。
まとめ
- 新シラバスの第1章は「ニューラルネットワーク」に出題が集中する。学習の仕組み、過学習、代表的なモデルがここに入る
- 機械学習の手法は「正解ラベルの与え方」で見分ける。教師ありは分類と回帰、教師なしはクラスタリングと次元削減、強化学習は報酬・価値・方策
- 学習の流れは「予測(活性化関数)→ずれを測る(損失関数)→さかのぼる(誤差逆伝播法)→直す(勾配降下法)」
- 過学習の対策はアーリーストッピング・正則化・ドロップアウト。転移学習は別の目的の手法
- モデルは「何を入力して何を出すか」で見分ける。CNNは画像の特徴、RNN・LSTMは順番のあるデータ、VAEは圧縮と復元、GANは生成器と識別器
- 識別系AIは判定・分類、生成系AIは新しいデータを作る
- 歴史は第一次(探索・推論)/第二次(エキスパートシステム)/第三次(ビッグデータ・ディープラーニング)と、その先のTransformer→LLM・拡散モデル→ChatGPT
次の章では、この土台の上に立つ生成AIを、「技術・学習・生成」の流れで扱います。Transformer、事前学習とRLHF、ハルシネーションが起きる理由、主要なモデルまでです。
▶ 生成AIパスポート 第2章「生成AI」の要点|Transformer・学習と生成の仕組み・LLM・主要モデル
試験の概要と、勉強の順番は親記事に書いています。
▶ 生成AIパスポート試験の出題範囲を章別に学ぶ|5章まとめと学習ロードマップ
実際の試験の様子と、合格までにかけた勉強時間は、合格体験記にまとめています。
▶ 【合格体験記】生成AIパスポートの勉強方法|AIFとAI-900のあと、約10時間で合格した
この記事がお役に立ちましたら、コーヒー1杯分(300円)の応援をいただけると嬉しいです。いただいた支援は、より良い記事作成のための時間確保や情報収集に活用させていただきます。
システムエンジニア
AWSを中心としたクラウド案件に携わっています。
IoTシステムのバックエンド開発、Datadogを用いた監視開発など経験があります。
IT資格マニアでいろいろ取得しています。
AWS認定:SCS, ANS, AIP, SAP, DOP, SAA, DVA, SOA, CLF
Azure認定:AZ-104, AZ-300
ITIL Foundation
Oracle Master Bronze (DBA)
Oracle Master Silver (SQL)
Oracle Java Silver SE
■略歴
理系の大学院を卒業
IT企業に就職
AWSのシステム導入のプロジェクトを担当