当ブログにはPRを含みます。
この記事でわかること
- AIエージェントに設計・実装・レビュー・テストを任せる開発プロセスの具体的な工程表
- 6体のエージェントそれぞれの役割・入力・出力と、人間がどこを見ているか
- 割り当てられたクレジットが月半ばで尽きるという、コストの現実
- 生産性は上がったのに、それを回収できるかは契約形態次第という現実(人月と請負の差)
- コードを書かなくなった開発者たちが、実際に何と言っているか
はじめに
私は大手IT企業でPM(プロジェクトマネージャー)として、AWS上のサーバーレス構成で業務システムを開発するプロジェクトを担当しています。元請けの立場なので、自分でコードを書くよりも、開発プロセスを設計して複数のベンダーに実行してもらうのが主な仕事です。
そのプロジェクトで、いま人間はコードを書いていません。書いているのはAIで、人間はレビューをしています。
「AIにコードを書かせてみた」という記事はもう無数にありますが、業務システムの開発プロセスとして正式に組み込んだ話は、まだあまり見かけません。趣味の開発と違って、こちらには納期があり、品質の責任があり、複数社との分担の取り決めがあり、顧客への説明責任があります。その状態でどこまでAIに渡せるのか、という話です。
この記事では、実際に組んでいる工程表をできる限りそのまま書きます。そしてうまくいっていない部分も、同じくらいの分量で書きます。特にコストについては、導入を考えている方が一番先に知っておくべきことだと思うので、包み隠さず書きました。
システムの中身そのものではなく、どの工程を誰(どのAI)が担当して、人間がどこで判断しているか。その骨格の部分を取り出してご紹介します。
効いたのは、工程ごと作り替えたこと
先に結論を書きます。この取り組みで一番効いたのは、プロンプトの工夫でもモデル選びでもありませんでした。工程そのものをAI前提で組み直したことです。
生成AI自体は1年ほど前から使っていました。ただ当時は「とりあえずAIに書かせてみる」「レビューさせてみる」という程度で、各自が思い思いに触っている状態です。当然、効果が出る人と出ない人にはっきり分かれていました。
変わったのは、エージェントやスキルといった仕組みが整って、AIをプロジェクトの工程として必須化できるようになってからです。設計書はこのエージェントが書く、レビューはこのエージェントを通す、テストケースはこのエージェントが起こす。そうやって工程の側に埋め込んでしまうと、AIに詳しくないメンバーも使わざるを得なくなります。結果として、成果物の品質が一定のところまで底上げされました。
AI導入というと、どうしてもツールの話になりがちです。実際にやってみると、本体はプロセスの設計のほうにありました。
いまの工程表と、従来との違い
まず全体像です。左が従来の進め方、右が現在の進め方になります。
| 工程 | 従来(人間が実施) | 現在(AI前提) | 人間の関与 |
|---|---|---|---|
| 要件整理 | 打ち合わせ → 議事録 → 要件一覧を人間が起こす | 打ち合わせを録音し、文字起こしをコンテキストとしてAIに渡して要件を抽出させる | 抽出結果の妥当性を確認、抜け漏れを指摘 |
| 設計 | 設計者が設計書を書く | 設計エージェントが要件から設計書を生成 | 設計レビュー |
| 設計レビュー | 有識者がレビュー会を開く | 設計レビューエージェントが観点リストで一次指摘 | 一次指摘を踏まえて最終判断 |
| 実装 | 開発ベンダーがコーディング | 実装エージェントが設計書からコードを生成 | 生成物のレビュー |
| コードレビュー | 開発リーダーがレビュー | コードレビューエージェントが規約・脆弱性・設計整合を一次チェック | 指摘の採否を判断 |
| テスト設計 | テスト設計者が観点表・ケースを作成 | テスト設計エージェントが設計書からケースを起こす | 観点の網羅性を確認 |
| テスト実装・実行 | テスト担当がコードを書いて流す | テスト実装エージェントがテストコードを書いて実行し、結果を報告 | 失敗の切り分け結果を確認 |
| 進捗・品質管理 | 人間が集計 | 従来どおり人間(ここは後述のとおり課題あり) | 全面的に人間 |
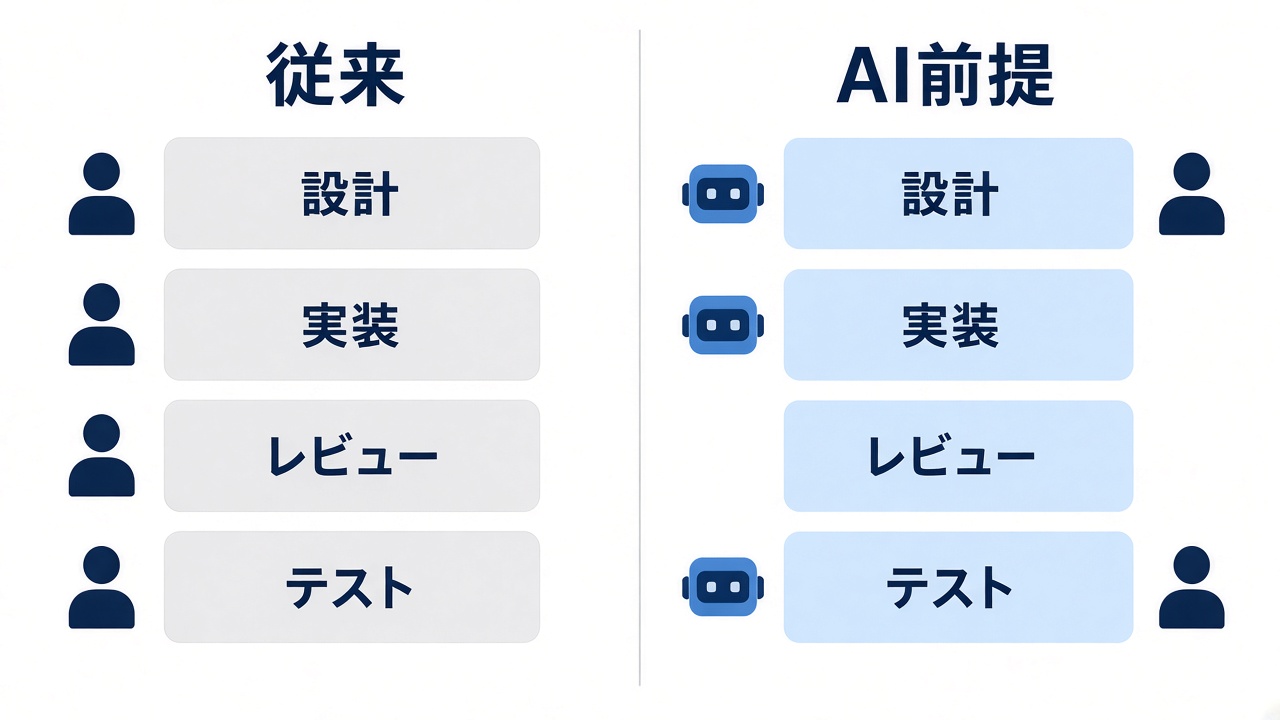
見ていただくとわかるとおり、工程の名前はほとんど変わっていません。設計・実装・レビュー・テストという枠組みは従来のまま残して、中の実行者だけをAIに差し替えています。
これは意図してそうしました。元請けの立場だと、成果物を顧客に説明する責任があり、複数ベンダーとの分担の取り決めもあります。工程の名前ごと作り替えてしまうと、見積りも契約も報告資料も全部作り直しです。器はそのままにして中身を入れ替えるほうが、組織の中では圧倒的に通しやすい。このあたりは、技術的な話というより政治の話に近いかもしれません。
AIエージェント6体の役割分担
現在は以下の6体に役割を割り当てています。1体の万能エージェントに全部やらせるのではなく、工程ごとに分けているのが特徴です。
| # | エージェント | 主な入力 | 主な出力 | 人間のレビュー観点 |
|---|---|---|---|---|
| 1 | 設計エージェント | 要件一覧、既存設計書、アーキテクチャ方針 | 設計書(画面・API・データ・処理フロー) | 要件との対応、非機能要件の考慮、既存機能との整合 |
| 2 | 設計レビューエージェント | 設計エージェントの出力、レビュー観点リスト | 指摘一覧(観点別) | 指摘の妥当性、見落としている観点の有無 |
| 3 | 実装エージェント | 確定した設計書、コーディング規約、既存コード | 実装コード | 設計書どおりか、既存の実装パターンから外れていないか |
| 4 | コードレビューエージェント | 実装コード、規約、セキュリティ観点 | 指摘一覧 | 指摘の採否、重要度の判断 |
| 5 | テスト設計エージェント | 設計書、テスト観点表 | テストケース一覧 | 観点の網羅性、異常系の考慮 |
| 6 | テスト実装・実行エージェント | テストケース、実装コード | テストコード、実行結果 | 失敗原因の切り分け結果の妥当性 |
なぜ役割を分けるのか
理由は2つあります。レビューの独立性を保つためと、1体が抱えるコンテキストの量を抑えるためです。
作った本人にレビューさせない
同じモデルに「設計して、実装して、レビューして」と一続きで頼むと、自分が書いたものを自分で肯定する方向に流れます。これは人間でも同じで、だからこそ実装者とレビュアーを分けるわけです。AIも工程を分けて入力を限定したほうが、素直に指摘が出てきます。
特に効いたのが、設計レビュー(2番)とコードレビュー(4番)を独立させたことでした。実装エージェントが持っている文脈はあえて渡さず、設計書とコードだけを見せて評価させます。作った側の事情を知らない人が読むほうが指摘が出る、というのは人間のレビューでも経験があると思います。
同じ理由で、テスト設計エージェント(5番)にも実装コードは渡していません。実装を見せると、実装の挙動に合わせたテストを書いてくるからです。テストは通るのに仕様は満たしていない、という状態は避けたいので、入力を設計書とテスト観点表だけに絞っています。
一体に持たせる情報を増やしすぎない
実務でより効いているのは、むしろこちらかもしれません。
生成AIは、与えるコンテキストが膨れすぎると出力の品質が落ちます。モデルが扱える上限の話だけではありません。上限に達していなくても、情報を詰め込むほど精度は落ちていきます。指示が多くなるほど、どれを優先すべきかが埋もれ、前半で伝えた制約を後半で無視する、といったことが起きてきます。
1体に全工程を任せると、そのエージェントは要件・設計・既存コード・コーディング規約・テスト観点・それまでのやり取りを全部抱えたまま作業を続けることになります。工程が進むほど文脈は積み上がるので、後半になるほど品質が落ちる。長丁場になるほど不利になる構造です。
工程ごとに分けてしまえば、それぞれが持つ情報はその工程に必要な分だけで済みます。
- 設計レビューエージェント → 設計書とレビュー観点リストだけ
- 実装エージェント → 確定した設計書と規約、参照すべき既存コードだけ
- テスト設計エージェント → 設計書とテスト観点表だけ
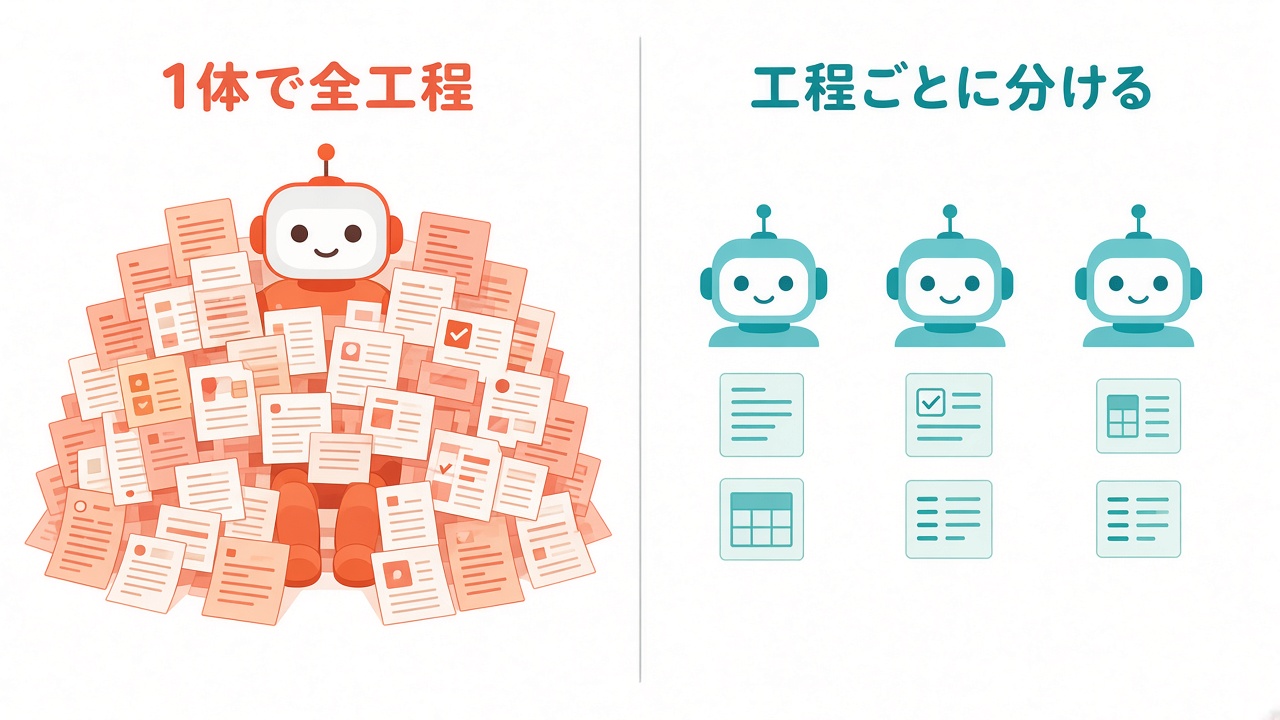
前の工程での議論の経緯や試行錯誤の履歴は、次には引き継ぎません。渡すのは確定した成果物だけです。こうすると、各エージェントが毎回きれいな状態から、狭い範囲の作業に集中できます。
役割分担というと組織論のように聞こえますが、やっていることの実態はコンテキストの設計でした。誰にどこまでの情報を渡すかを決める作業が、そのまま生成物の品質に返ってきます。人間のプロジェクトでも必要な人に必要な情報を渡す設計は重要ですが、そこはAIでも変わらないようです。
観点リストが思わぬ資産になった
2・4・5のエージェントには、レビュー観点やテスト観点のリストを与えています。これが、従来から使っていたレビュー観点表やテスト観点表でほぼそのまま間に合いました。
人間のレビュー品質を揃えるために長年整備してきたチェックリストが、そのままAIへの指示として機能する。これは正直、やってみるまで思いつきませんでした。これまでの蓄積がそのまま効いた、数少ない場面です。
この形は、どこから持ってきたか
念のため書いておくと、最初から6体の分担を思いついたわけではありません。1年前は前述のとおり、各自が好き勝手にAIを触っている状態でした。
転機になったのは、AIに複数の役割を持たせてチームとして動かすという考え方の型を知ったことです。私はUdemyの以下の講座でその型を学んで、自分のプロジェクトに合わせてアレンジしました。
AIマルチエージェント入門 -Claude Codeで学ぶ「AI専門家チーム」の作り方-
AIエージェントに役割を与えてチームを組ませる考え方を、体系的に学べる講座です。Claude Codeを題材にしていますが、中身は「専門家チームをどう設計するか」という設計の話が中心なので、ツールに依存しない部分が多いのが良いところでした。
ただ、講座の内容をそのまま持ち込んだわけではありません。業務に入れるにあたっては、次の3点を作り替えています。実務導入の本体はここだと思っています。
| アレンジした点 | 具体的にやったこと |
|---|---|
| 工程に合わせてエージェントを切り直す | 学んだ役割分担の型を、自分のプロジェクトの工程(設計 → 設計レビュー → 実装 → コードレビュー → テスト設計 → テスト実装)に対応させる形で6体に再定義した |
| 会社で使えるAIツールに合わせる | 業務では利用できるサービスや環境が決まっているので、その制約に合わせて実現方法を置き換えた |
| 既存の資産を入力に組み込む | 前述のレビュー観点表・テスト観点表・コーディング規約を、エージェントへの入力として固定した |
型を知らずにゼロから設計すると遠回りになりますし、かといって型だけ真似ても現場では動きません。考え方を学んでから、自分の工程と使えるツールに合わせて作り替える。振り返ってみると、この順番が一番早かったと思います。
1つの機能ができるまでの流れ
具体的に、1機能が出来上がるまでの流れです。
- 要件の確定:顧客との打ち合わせを録音し、文字起こしをコンテキストとして渡して要件候補を抽出させる。人間が取捨選択して要件一覧を確定する
- 設計:設計エージェントが設計書を生成する
- 設計の一次レビュー:設計レビューエージェントが観点別に指摘を出す。設計エージェントが指摘を反映する
- 設計の確定:人間がレビューし、承認する(人間の関門①)
- 実装:実装エージェントが設計書からコードを生成する
- コードの一次レビュー:コードレビューエージェントが指摘を出し、実装エージェントが直す
- テスト設計:テスト設計エージェントが設計書からテストケースを起こす
- テスト実装・実行:テスト実装エージェントがテストコードを書いて実行し、結果を報告する
- 成果物の確定:人間がコード・テスト結果をレビューし、承認する(人間の関門②)
人間が止まる場所は、設計の確定と成果物の確定の2か所だけです。その間の3〜8はAI同士のやり取りで進みます。
従来なら、複数社の開発メンバーが分担して数日から数週間かけていた範囲です。ここが変わると、手戻りの起き方まで変わってきます。以前の最大のリスクは「最後に作り上げてから、思っていたものと違うと判明する」ことでした。いまは作るコストが下がったので、一度70点のものを出して、それを見てもらいながら詰めていくやり方が現実的になっています。
残ったのはレビューだけ、なのに楽にはなっていない
「人間はレビューだけ」と書くと楽そうに聞こえるかもしれません。実際にはレビューの負荷はむしろ上がりました。
単純に量が増える
生成が速いので、レビュー待ちの成果物がどんどん積み上がります。以前は実装に時間がかかっていた分、レビュアーには待ち時間という余裕がありました。それがなくなり、ボトルネックが実装からレビューへ完全に移動しています。プロセスを設計するときは、レビューの処理能力のほうを制約条件として計画に織り込む必要があります。
体裁が整っているぶん、見抜きにくい
人間が書いた未熟なコードは、見ればだいたい未熟だとわかります。AIが書いたコードは、間違っていても体裁が整っている。読み流すと通ってしまいます。
レビューのやり方そのものも変わりました。従来は「書いた人の意図を確認する」作業でしたが、いまは意図を説明してくれる相手がいません。出てきた成果物だけを見て判断することになります。
設計レビューの重みが増した
実装がほぼ自動で走るので、設計が間違っていると間違ったものが高速で大量に出来上がります。上流のレビューの重要度は、相対的にかなり上がりました。
こうして並べてみると、人間の仕事は「作る」から「決める・評価する」に寄ったということだと思います。
「説明するより自分でやった方が早い」という罠
ここで、AIとは直接関係のない昔の失敗談を書かせてください。今回の取り組みで、同じ失敗をAI相手にも繰り返しかけたことに気づいたからです。
私は若手の頃、かなりの何でもやりたがりでした。PMの立場なのに、自分でコードを書き、自分で設計し、デプロイまで自分でやる。結果どうなったかというと、作業を抱え込んだ分だけマネジメントに手が回らなくなって、炎上の一歩手前まで行きました。
当時の言い訳ははっきり覚えています。「人に説明するより、自分でやった方が早い」です。
一回だけを切り取れば、これは正しいこともあります。間違っているのは、作業は一回では終わらないという点でした。二回目、三回目と積み重なれば、最初に教えたコストはすぐに回収されます。多少の時間を払ってでも、やり方を人に移していくことには価値がある。これは失敗から学んだことで、いまは引き継ぎに時間がかかっても積極的に移管するようにしています。
そしてAI相手にも、まったく同じことが起きます。
エージェントに渡す観点リストを整備したり、既存の実装パターンを参照させる仕組みを作ったりするのは、面倒な作業です。目の前の1機能だけを見れば、自分で書いたほうが確実に早い。ここで「今回は自分でやるか」と手を出し始めると、AI前提のプロセスはいつまでも立ち上がりません。
AIに任せられない人は、だいたい人にも任せられていない。自分への戒めも込めて、そう思っています。指示を整備するコストを最初に払えるかどうかが、この進め方が回るかどうかの分かれ目でした。
ただ、誤解のないように付け加えておくと、若手の頃に何でも抱え込んだ経験そのものは無駄ではありませんでした。むしろ資産になっています。いまでもコードを書こうと思えば書けますし、設計もアーキテクチャの検討もデプロイもできる。その引き出しがあるから、AIが出してきた成果物を評価できるし、パートナーの開発者にも指導ができます。抱え込みは失敗でしたが、そこで得た経験だけは手元に残りました。
うまくいっていないこと
割り当てられたクレジットが、月半ばで尽きる
私のいる環境では、AIの利用クレジットが一人あたり月単位で割り当てられています。最初に金額を聞いたときは、これだけあれば十分だろうと思う水準でした。
実際には、だいたい月半ばで使い果たします。
しかも、いまはまだ開発が佳境ではありません。試験を回している段階でこれです。開発が本格化すれば、枯渇はもっと早まるでしょう。尽きた場合に上限を引き上げるルートはあるので業務が止まることはありませんが、トークンのコストはこれからどんどん膨らんでいく前提で考えたほうがよさそうです。
「AIで開発コストが下がる」という話はよく聞きます。実務の感覚としては、人件費が減った分がそのままトークン代に流れているというのが近い。ゼロになるわけではなく、コストの置き場所が移っただけです。ここを見誤ると、予算の組み方を間違えます。
人月ビジネスと噛み合わない
実はこちらのほうが、根が深い問題だと思っています。
SIの仕事の多くは、いまも工数ベースの商売です。一人が一か月働いたらいくら、という形で見積り、請求します。この形のまま生成AIを入れると、どうなるか。
こなせる仕事量はどんどん増えます。増えますが、売上はそれに比例しません。
仕事量だけが膨れ上がって、その裏でトークンのコストが積み上がっていく。ビジネスモデルとして見たとき、いまのままでは儲からない構造になりかねません。
もっとも、これは契約形態によってまったく話が変わります。請負であれば、生産性が上がった分はそのまま利益になります。同じものを短い期間で作れるなら、トークン代を引いても十分に見合う。厄介なのは工数で請求する形の仕事のほうで、作業効率がどれだけ上がっても、請求できる金額は変わりません。
理想を言えば、人月の費用とは別に生成AIの利用料を請求できるのが筋です。実際にかかっている費用なので、当然といえば当然の話ではあります。ただ、AI開発に対する世の中の理解がまだ追いついていないところがあって、見積書に「AI利用料」という行が増えると、パッと見では単なる値上げに見えてしまう。ここが難しいところです。
「AIを使えば安くなるんでしょう」という期待と、「AIを使うから実費がかかります」という現実。この間をどう埋めるか、私もまだ答えを持っていません。おそらく業界全体で、これから数年かけて相場や商習慣が作られていく部分なのだろうと思います。
品質の見方が通用しなくなった
これも答えが出ていません。
従来の品質管理では、開発規模に対してテストケース数が足りているか、バグの出方が想定の曲線に乗っているか、バグの傾向に偏りがないか。そういったところを見て、まずい兆候を早めに掴んでいました。この経験則は、人間が書いたコードの性質を前提に組み立てられたものです。
AIが書いたコードでは、その前提が崩れます。テストケース数にしても、生成させればいくらでも増やせるので、量を指標にする意味が薄れました。では何を見れば品質を判断できるのか。ここは私の中でも整理しきれていないので、別記事で改めて考えたいと思っています。
現場の開発者はどう受け止めたか
導入を進めるうえで、一番気を遣ったのはここでした。これまでコードを書く仕事を引き受けてくれていた開発ベンダーの方々に、「これからはAIが書きます」と伝えることになるわけですから。
返ってきた反応は、予想とは少し違いました。
いただいたコメントで一番多かったのが、「いつかこうなるとは思っていた。ただ、思っていたより時期がずっと早かった」というものです。AIがコードを書くようになって自分たちの仕事が変わっていくことは、前々から感じていた。ただ、本当にコードを書かなくてよくなるのがこんなに早いとは思わなかった、と。
もうひとつ多かったのが、AIの進化の速さそのものへの驚きでした。1年ほど前から使っているからこそ、当時との差を肌で感じている。これについては、私もまったく同じ感想です。
想定していなかった良い効果もありました。新人のSEが入ってきたときに、AIにコーディングとレビューをさせることで一定の品質が出るようになったことです。経験の浅いメンバーの成果物が、いきなりレビュー可能な水準に乗ってくる。技術力の底上げという意味では、かなり良い方向に働いていると感じます。
もっとも、そうなると今度は「では新人はどこで経験を積むのか」という問題が出てきます。これは私自身まだ答えを持てていないので、稿を改めて書きます。
なぜ「ツールを配るだけ」では回らないのか
大企業は生成AIに保守的だと思われがちですが、実際はそうでもありません。私の周りでも、セキュリティ面の検討を経たうえで「どんどん使うように」という方針が出ていますし、主要なAIサービスは社員に一律で提供されています。ツールは揃っているのです。
一方で、「この工程ではAIをこう使う」というルールのほうは、まだ整備されていません(2026年9月時点)。ツールは配られたが、使い方は各自の工夫に任されている段階です。
この状態を放置するとどうなるか。答えははっきりしていて、二極化します。自分で使い方を考えて業務に取り込む人と、結局ほとんど使わない人に分かれる。個人の関心と裁量に委ねている限り、これは避けられません。1年前の自分たちが、まさにその状態でした。
| ツールを配るだけ | 工程に埋め込む | |
|---|---|---|
| 使う人 | 関心のある人だけ | 全員(使わないと工程が進まない) |
| ノウハウ | 個人に溜まる | プロセスとして共有される |
| 品質 | 人によってばらつく | 観点リストで揃う |
| 属人性 | 上がる | 下がる |
| 横展開 | できない | できる |
私のプロジェクトでやっているのは右側です。AIに詳しくないメンバーでも、その工程を進めようとすれば自然と使うことになる。そういう工程を設計して運用しています。
このルールを設計する仕事こそが、元請けの価値だとも思っています。開発を担当する会社は、元請けが決めたプロセスの中で作業することになります。そのプロセス自体を設計して、複数社に展開できる立場にいるのが元請けです。自分で考えた進め方を組織の標準として動かせるのは、大手SIerで働く面白さのひとつだと感じています。
逆に言えば、自分の手でコードを書き続けたい方にとっては、この方向性はミスマッチかもしれません。このあたりはクラウドエンジニア採用で評価されるのは資格か実務経験か?採用側の視点でも触れています。
では、何を勉強すればいいのか
「AIがコードを書くなら、人間は何を勉強すればいいんですか」という質問をよく受けます。ここまで運用してみた実感としては、評価する側に必要な知識のほうが価値を増した、という感じです。
毎日発生しているのは、たとえばこういう判断です。
- 生成されたアーキテクチャは、この非機能要件を満たすか
- この権限設定は、必要以上に広くないか
- このデータの持ち方で、法令上の保存期間の要件を満たせるか
- この構成のコストは、想定の範囲に収まるか
- 提示された選択肢のうち、この顧客が重視している観点ではどれが妥当か
これらはAIに聞いても、判断そのものは返ってきません。もっともらしい答えは返ってきますが、採用するかどうかを決めるのは人間です。そして、この判断に必要な知識は、クラウド資格の出題範囲とかなり重なります。
AWS認定の各試験で問われる「要件に対して適切なサービスを選ぶ」という訓練は、そのまま生成物の妥当性を判断する力になります。セキュリティ系の出題範囲、つまり権限設計や暗号化、監査ログのあたりは、生成コードのレビューで実際に最も指摘が多い領域です。生成AIそのものの用語やリスク、責任あるAIの考え方については、AWS Certified AI Practitioner(AIF-C01)の出題範囲として体系化されています。
先ほど、若手の頃に抱え込んだ経験が資産になったと書きました。AIの出力を評価できるのは、自分で手を動かした経験があるからです。ただ、これから経験を積む方が同じ道を通れるとは限りません。だからこそ、体系化された知識で土台を作る手段としての資格の価値は、むしろ上がっていると考えています。
資格が「作れること」の証明としての意味は弱まる一方で、「判断できること」の土台としての意味は強くなっている。少なくとも、いまの現場から見える景色はそうです。
よくある質問
Q. 本当に人間は1行もコードを書いていないのですか?
プロジェクトの通常の開発作業では書いていません。ただし、AIへの指示(エージェントの定義や観点リスト)を整備するのは人間の仕事ですし、切り分けのために手を動かすこともあります。「機能の実装作業を人間が担当していない」という意味で捉えてください。
Q. 結局、コストは下がったのですか?
作る部分のコストは確実に下がりました。ライン数あたりのコストは大幅に減りましたし、一人がこなせる作業量も大幅に増えています。
問題は、それを回収できるかどうかが契約形態次第だという点です。人月商売では、生産性が上がっても請求できる金額は変わらないので、回収が難しい。一方、請負開発であれば生産性の向上はそのまま利益に直結します。同じものを短い期間で作れるなら、トークン代を引いても十分に見合うはずです。
つまり「コストが下がったかどうか」と「儲かるようになったかどうか」は別の話で、後者は自分たちがどういう契約で仕事をしているかに左右されます。
Q. 開発ベンダーからの反発はありませんでしたか?
強い反発というより、「いつか来ると思っていたが、思っていたより早かった」という受け止めが多かったです。作業の中身が変わる話なので、事前の説明は丁寧に行う必要があります。
Q. セキュリティは問題ないのですか?
会社として利用が許可されている環境で、承認されたサービスを使っています。ここは個人の判断で進められる領域ではないので、必ず自社のルールを確認してください。
Q. 小さいチームでも真似できますか?
工程を分ける、レビュアー役を独立させる、観点リストを入力として固定する。この3点は規模に関係なく効きます。むしろ小さいチームのほうが導入は速いはずです。ただしトークンコストの問題は、小さい組織のほうが重くのしかかります。
Q. どのモデル・ツールを使えばいいですか?
業務で使う場合は、自社で利用が認められているサービスに合わせるのが前提になります。この記事の工程の分け方は、特定のモデルやツールに依存しない部分を取り出しているので、手元の環境に置き換えて考えていただけます。まず考え方の型から入りたい方は、本文で紹介したAIマルチエージェント入門がClaude Codeを題材に一通りたどれます。
Q. 何から手を付けるのがよいですか?
いきなり全工程を置き換えようとすると、どこで失敗したのか切り分けられなくなります。まずはレビュー工程のように、出力を人間が検証しやすい工程をひとつ選んで、観点リストを入力として固定するところから始めるのがおすすめです。
まとめ
- AI導入の本体はツールの配布ではなく、工程の再設計だった
- 工程の器(設計・実装・レビュー・テスト)は従来のまま残し、実行者だけをAIに差し替えると組織で通しやすい
- エージェントは6体に分割。レビュー役とテスト設計役には、作った側の文脈を渡さない
- 役割分担の実態はコンテキストの設計。膨れると品質が落ちるので、各エージェントには必要最小限だけを渡し、次工程には確定した成果物だけを引き渡す
- 考え方の型を学んでから、自分の工程と使えるツールに合わせてアレンジするのが結局いちばん早い
- 人間が止まるのは「設計の確定」と「成果物の確定」の2か所。ただしレビュー負荷はむしろ上がる
- 「説明するより自分でやった方が早い」は、人への移管でもAIへの移管でも同じ罠
- コストは消えない。割り当てられたクレジットは月半ばで尽きるし、しかもまだ試験段階でこれ
- ライン数あたりのコストは大幅に下がり、一人がこなせる量も増えた。ただし回収できるかは契約形態次第で、人月商売では回収しづらく、請負なら利益に直結する
- 従来の品質管理の経験則(バグ曲線・ケース数)は通用しない。ここは未解決
- 開発者の受け止めは「いつか来ると思っていたが、早すぎた」
- 価値が上がったのは、作るスキルより評価するスキル
関連ハブ記事: AWS資格は転職・キャリアアップでどう活きる?資格別市場価値と実体験
関連記事: クラウドエンジニア採用で評価されるのは資格か実務経験か?採用側の視点|エンジニアからPL・PMへ:社内昇格の実体験
AIエージェントの組み方を学びたい方はこちら:
この記事で紹介した役割分担の考え方を、Claude Codeを題材に手を動かしながら学べます。あとは自分の工程と、職場で使えるツールに合わせて作り替えるだけです。
生成AIの知識を体系的に整理したい方はこちら:
【AIF-C01】AWS Certified AI Practitioner 概要とおすすめ勉強方法
著者:Kaneko(syo)。大手IT企業勤務・PM・AWS全12資格保有。AWSサーバーレス構成の業務システム開発で、AIエージェントを組み込んだ開発プロセスの設計・運用を担当。
この記事がお役に立ちましたら、コーヒー1杯分(300円)の応援をいただけると嬉しいです。いただいた支援は、より良い記事作成のための時間確保や情報収集に活用させていただきます。
システムエンジニア
AWSを中心としたクラウド案件に携わっています。
IoTシステムのバックエンド開発、Datadogを用いた監視開発など経験があります。
IT資格マニアでいろいろ取得しています。
AWS認定:SCS, ANS, AIP, SAP, DOP, SAA, DVA, SOA, CLF
Azure認定:AZ-104, AZ-300
ITIL Foundation
Oracle Master Bronze (DBA)
Oracle Master Silver (SQL)
Oracle Java Silver SE
■略歴
理系の大学院を卒業
IT企業に就職
AWSのシステム導入のプロジェクトを担当