Claude認定アーキテクト(CCAR-F)の無料問題集です。正解と解説を確認する際は右側のボタンを押下してください。
問題集の完全版は以下Udemyにて発売しているためお買い求めください。問題集への質問はUdemyのQA機能もしくはUdemyのメッセージにて承ります。Udemyの第1回の模擬試験から10問抜粋しております。
多くの方にご好評いただき、講師評価 4.5/5.0 を獲得できております。ありがとうございます。
特別価格: 通常2,600円 → 1,500円
講師クーポン適用で42%OFF
Claude Certified Architect Foundations CCAR-F 模擬試験200問【図解付き】
この試験の勉強方法
合格体験記
→【合格体験記】Claude認定アーキテクト(CCAR-F)の勉強方法|AIに作らせた教材で約2週間、862点で合格
無料の学習ノートと音声
→ Claude認定アーキテクト(CCAR-F)学習ノート
問題文:
シナリオ:マルチエージェントリサーチシステム
あなたは、Claude Agent SDKを使用してマルチエージェントリサーチシステムを構築しています。コーディネーターエージェントが、専門化されたサブエージェントに作業を委任します。サブエージェントには、ウェブを検索するもの、ドキュメントを分析するもの、調査結果を統合するもの、レポートを生成するものがあります。このシステムはトピックを調査し、出典を明記した包括的なレポートを作成します。
顧客対応のマルチエージェント構成で、調査サブエージェント(subagent)が、問い合わせに該当する注文を特定しました。次に、返金判定サブエージェントがその注文を確かめます。この2つのサブエージェントの間で、情報は通常どのように渡りますか。
選択肢:
A. 調査サブエージェントの終了時に SubagentStop フックが返金判定サブエージェントを起動し、調査結果を起動時の入力として渡します。
B. 調査サブエージェントが返金判定サブエージェントを直接呼び出し、特定した注文の情報を、呼び出しの引数として渡します。
C. 調査サブエージェントの結果はコーディネーターに返り、コーディネーターが必要な部分を返金判定サブエージェントへの依頼のプロンプトに入れます。
D. 返金判定サブエージェントはコーディネーターの会話履歴を継承して起動し、その中にある調査サブエージェントの結果を読み取ります。
正解:C
A. 調査サブエージェントの終了時に SubagentStop フックが返金判定サブエージェントを起動し、調査結果を起動時の入力として渡します。
不正解 SubagentStop フック(hooks)は、サブエージェントが終わったときに処理を差し込むための仕組みです。次のサブエージェントを起動して結果を渡す役割は持たず、その役割はコーディネーターが担います。
B. 調査サブエージェントが返金判定サブエージェントを直接呼び出し、特定した注文の情報を、呼び出しの引数として渡します。
不正解 サブエージェントどうしを直接つなぐ方法です。既定ではサブエージェントが別のサブエージェントを起動でき、SendMessage で名前のあるエージェントへも送れます。親を介さない呼び出しでは、途中結果の選別とエラーの扱いがコーディネーターに集まらず、どれを次に渡すかと失敗したときの扱いが呼び出し元に残ります。
C. 調査サブエージェントの結果はコーディネーターに返り、コーディネーターが必要な部分を返金判定サブエージェントへの依頼のプロンプトに入れます。
正解 サブエージェントの最終結果は親であるコーディネーターに返ります。サブエージェントは新しいコンテキストで始まるため、コーディネーターが次のサブエージェントを呼ぶときに、必要な情報を依頼のプロンプトに直接入れて渡します。
D. 返金判定サブエージェントはコーディネーターの会話履歴を継承して起動し、その中にある調査サブエージェントの結果を読み取ります。
不正解 サブエージェントは、フォークでない限り新しいコンテキストで始まり、親の会話履歴は継承しません。このフォークは親の会話をコピーする SDK の起動で、スキルの context: fork ではありません。返金判定へ渡るのは最終結果で、コーディネーターが次の依頼に入れます。
問われている要件
- サブエージェントの最終結果を、コーディネーターが次の依頼のプロンプトに入れて渡すこと
- 途中のツール結果を広げず、次の作業に要る部分だけを渡すこと
前提知識
ハブアンドスポークの情報の流れについて
- コーディネーターは、サブエージェント間の通信、エラー処理、情報のルーティングを管理します。可観測性、一貫したエラー処理、制御された情報の流れのために、通信はコーディネーターを経由します
- 途中のツール呼び出しや結果はそのサブエージェントの会話に残り、親へ返るのは最終のメッセージです。コーディネーターは必要な部分を選び、次のサブエージェントへの依頼のプロンプトに入れます
- 既定ではサブエージェントが別のサブエージェントを起動でき、
SendMessageで名前のあるエージェントへも送れます。通常の受け渡しは、コーディネーターが最終結果の必要な部分を次の依頼に入れることです
サブエージェントが受け取るコンテキストについて
- フォークでないサブエージェントは新しいコンテキストで始まり、親の会話履歴は継承せず、親のツール結果も受け取りません。呼び出しのあいだでメモリも共有しません
- 親の会話から渡るのは、Agent ツールのプロンプト文字列です。サブエージェント自身のシステムプロンプトとツール定義は別に持ちます。フォークのときだけ、親の会話をコピーして始まります
- このフォークは SDK の起動の仕組みです。スキルの
context: forkは、スキルを別の会話で実行して結論だけを戻すもので、親の会話全体を子に持たせる仕組みではありません
SubagentStop について
-
SubagentStopは、サブエージェントが終了したときに呼ばれるフックです。ログの記録や結果の確認などの処理を差し込むために使い、次のサブエージェントを起動して結果を渡す経路にはなりません
図による解説
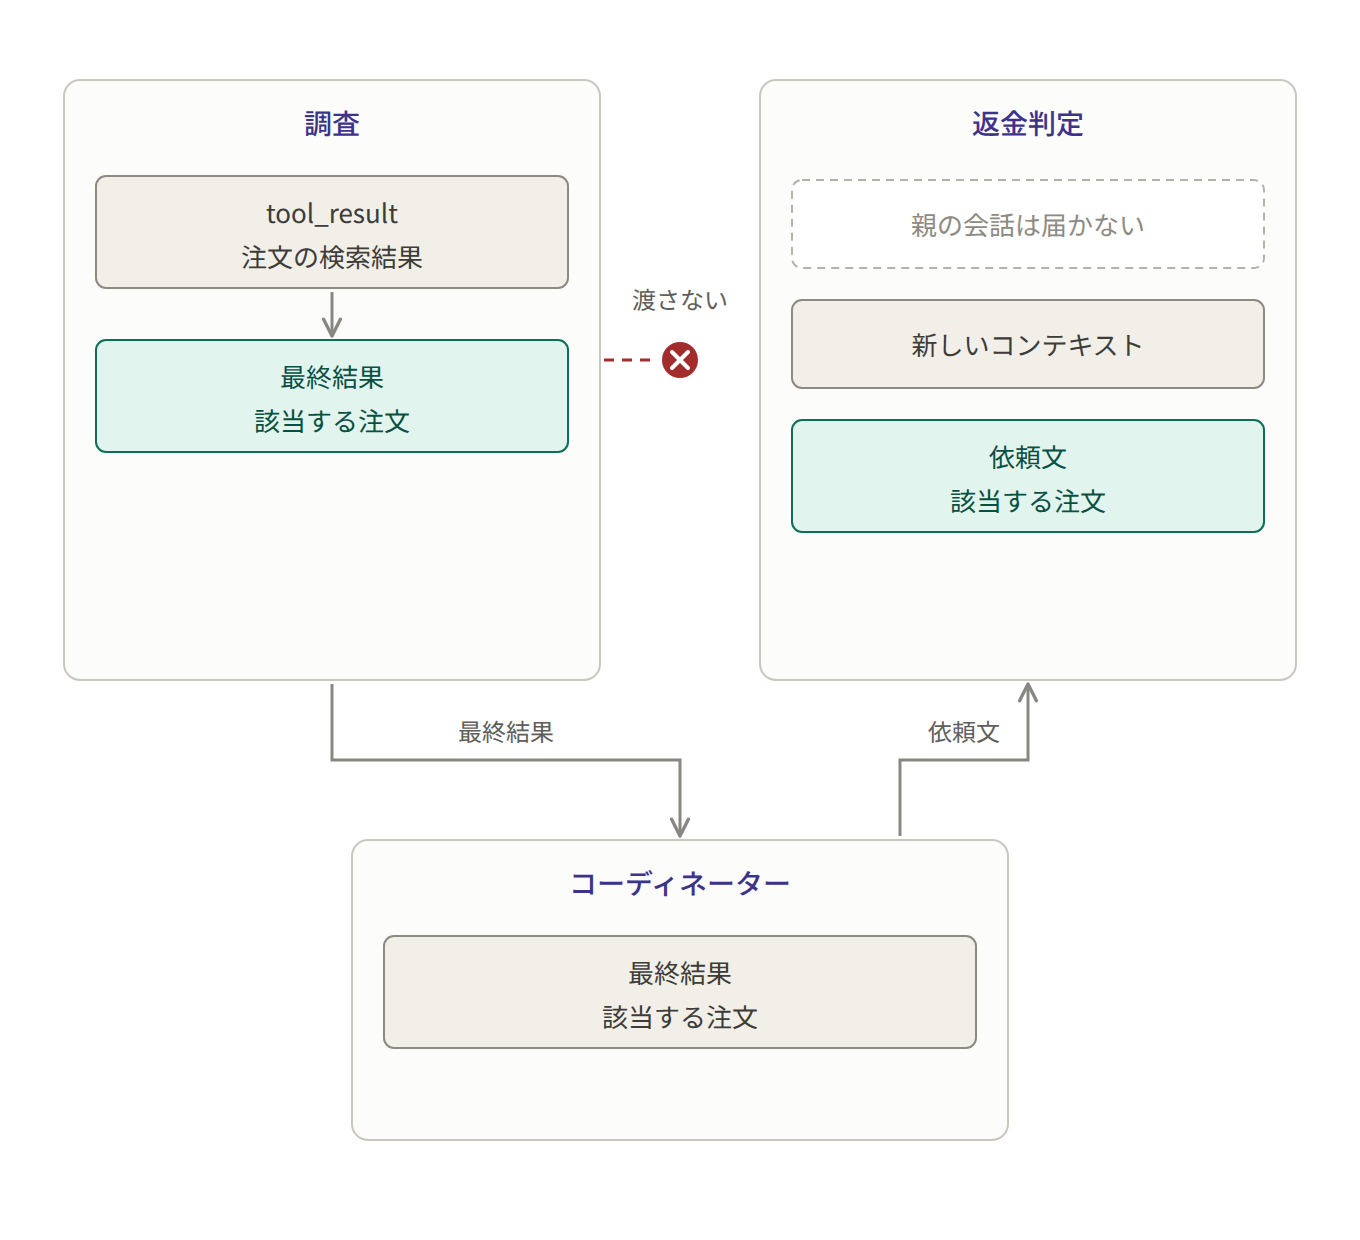
調査サブエージェントの tool_result にある注文の検索結果は、その会話の中に残ります。返金判定へ渡るのは、該当する注文という最終結果だけです。コーディネーターがそれを次の依頼文に載せるので、返金判定は親の会話を見なくても判定できます。検索結果そのものを渡さないことで、次の依頼は必要な注文だけを材料にします。
解くための考え方
調査の結果を返金判定へ渡すとき、途中の検索結果は調査側の会話に残り、コーディネーターへ返るのは最終のメッセージです。コーディネーターがその注文の情報を、返金判定を起動する依頼のプロンプトに入れます。返金判定は親の履歴を見なくても、依頼に書かれた内容で判定できます。
SubagentStop は終了時に処理を差し込むフックで、次のサブエージェントを起動して結果を渡す役はありません。サブエージェントどうしの直接呼び出しや SendMessage は既定でも使えますが、親を介さない呼び出しでは途中結果の選別とエラーの扱いがコーディネーターに集まりません。フォークでない起動は親の会話履歴を継承しないので、返金判定が調査の結果を会話履歴から読むこともありません。
参考資料
問題文:
シナリオ:マルチエージェントリサーチシステム
あなたは、Claude Agent SDKを使用してマルチエージェントリサーチシステムを構築しています。コーディネーターエージェントが、専門化されたサブエージェントに作業を委任します。サブエージェントには、ウェブを検索するもの、ドキュメントを分析するもの、調査結果を統合するもの、レポートを生成するものがあります。このシステムはトピックを調査し、出典を明記した包括的なレポートを作成します。
ある企業は Claude Agent SDK で障害調査のエージェントを作っています。コーディネーター(coordinator)は、アプリケーションのログを調べるサブエージェント(subagent)と、直近のデプロイ履歴を調べるサブエージェントに作業を任せ、2つの結果を受け取って原因をまとめます。2つの調査はどちらも相手の結果を必要としませんが、記録を見ると、コーディネーターは一方を起動して結果を待ち、その後でもう一方を起動しています。コーディネーターが結果をまとめる今の流れは保ったまま、2つの調査を同時に進めるにはどうしますか。
選択肢:
A. エージェントの外に非同期の処理を用意し、コーディネーターとサブエージェントの組を調査ごとに別々のスレッドで動かして、最後に結果を連結します。
B. コーディネーターが、2つのサブエージェントを起動するツール呼び出しを、別々のターンに分けずに1回の応答の中でそろえて出すようにします。
C. ログとデプロイ履歴を調べる役割を1つのサブエージェントにまとめ、1回の委任で両方の調査を続けて行わせて、起動の回数を減らします。
D. 各サブエージェントの定義(AgentDefinition)で maxTurns を小さくし、1回の調査で使うターン数を減らして、それぞれのサブエージェントが早く結果を返すようにします。
正解:B
A. エージェントの外に非同期の処理を用意し、コーディネーターとサブエージェントの組を調査ごとに別々のスレッドで動かして、最後に結果を連結します。
不正解 調査ごとに独立したコーディネーターを動かすため、同時には進みますが、1つのコーディネーターが2つの結果を受け取って原因をまとめる流れがなくなります。問題文の「結果をまとめる今の流れは保ったまま」という条件を満たしません。
B. コーディネーターが、2つのサブエージェントを起動するツール呼び出しを、別々のターンに分けずに1回の応答の中でそろえて出すようにします。
正解 Claude は1回の応答に複数のツール呼び出しを含められ、互いに依存しない呼び出しは同時に実行されます。サブエージェントの起動もツール呼び出しなので、2つを同じ応答で出せば両方の調査が並行して進み、結果は従来どおりコーディネーターに戻ってまとめられます。
C. ログとデプロイ履歴を調べる役割を1つのサブエージェントにまとめ、1回の委任で両方の調査を続けて行わせて、起動の回数を減らします。
不正解 起動の回数は減りますが、1つのサブエージェントの中でログとデプロイ履歴を続けて調べるため、2つの調査は順番に進みます。待ち時間の原因である逐次の処理は残り、同時に進めることにはなりません。
D. 各サブエージェントの定義(AgentDefinition)で maxTurns を小さくし、1回の調査で使うターン数を減らして、それぞれのサブエージェントが早く結果を返すようにします。
不正解 maxTurns は1つのサブエージェントが繰り返すターン数の上限です。各調査は早く打ち切られますが、コーディネーターが一方の結果を待ってからもう一方を起動する順序は変わらず、同時には進みません。
問われている要件
- 互いに依存しないサブエージェントの調査を同時に進めること
- コーディネーターが結果を受け取ってまとめる構成を保つこと
前提知識
1回の応答での並列実行について
- Claude は1回の応答に複数の
tool_useを含められます。互いの結果を必要としない呼び出しは、ハーネスが同時に実行し、結果を次のリクエストでまとめて返します - サブエージェントはコーディネーターの Agent ツール(旧称は Task)で起動します。起動もツール呼び出しなので、別のターンに分けず、1回の応答で複数の起動を出すと、それらは同時に動きます
- 結果はそれぞれコーディネーターに戻るので、結果をまとめる役割はコーディネーターに残ります
同時には進まない別の方法について
- 調査ごとに別のコーディネーターをスレッドで動かすと、処理は重なりますが、1つのコーディネーターが両方の結果を受け取ってまとめる流れではなくなります
- 役割を1つのサブエージェントにまとめると、その会話の中では作業が順番に進みます。起動の回数は減っても、2つの調査は重なりません
-
maxTurnsは1つのサブエージェントが繰り返すターン数の上限です。上限を下げると各調査は早く打ち切られますが、コーディネーターが起動する順番はそのままです
図による解説
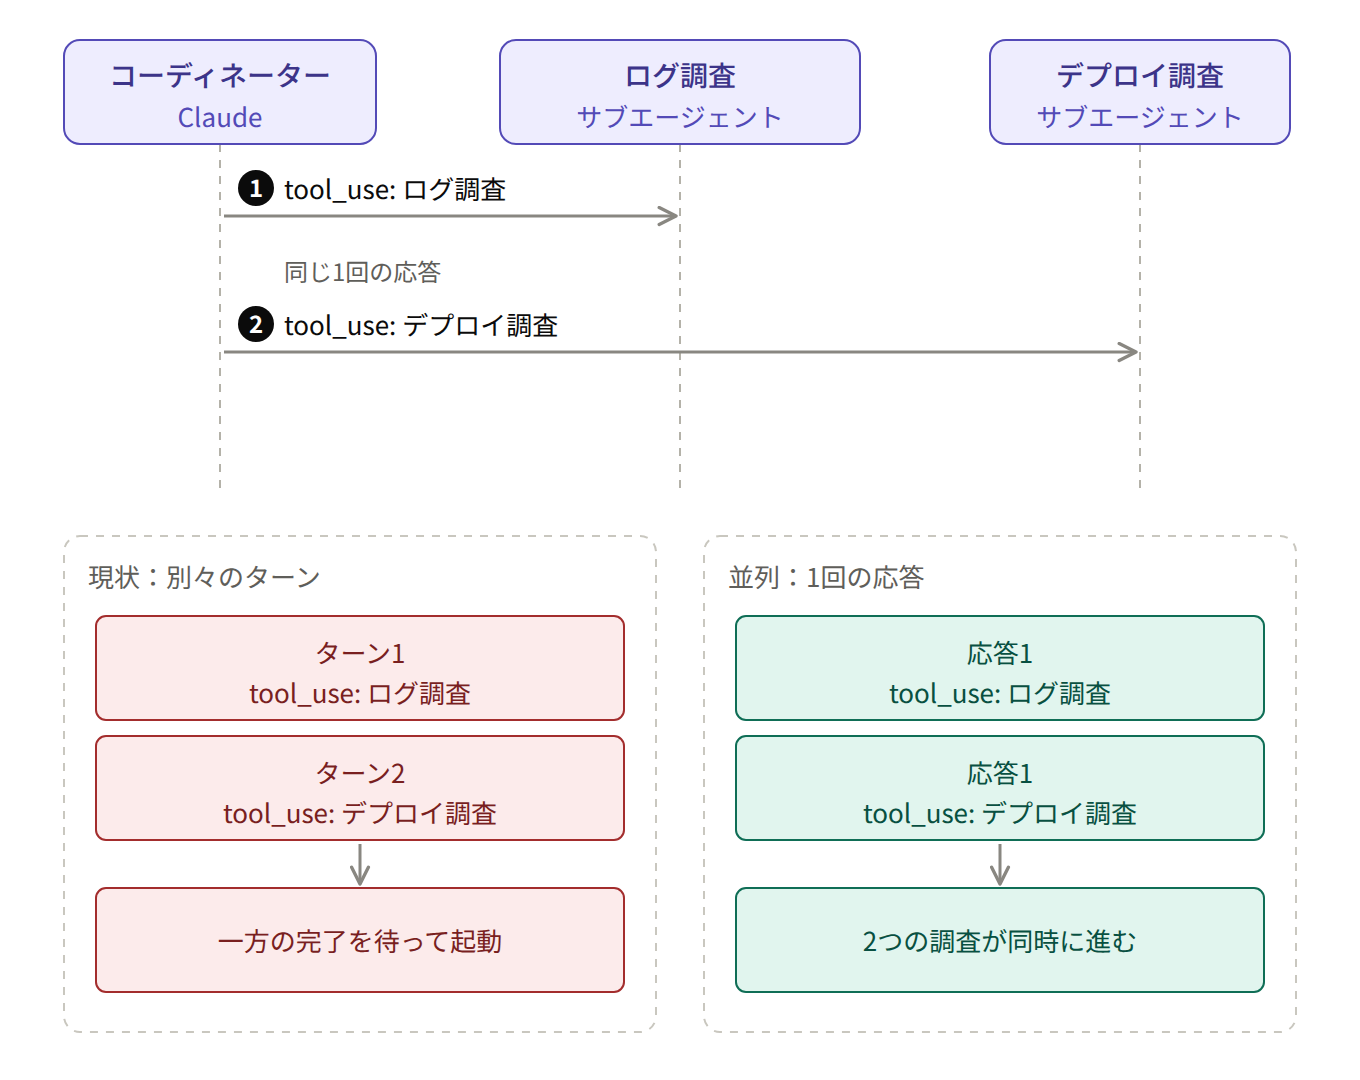
ログ調査とデプロイ調査を1回の応答に並べると同時に進み、別ターンでは逐次になります(①②)。コーディネーターが同じ1回の応答で①のログ調査と②のデプロイ調査を出すと、2つのサブエージェントは互いの完了を待たずに進みます。別々のターンに分けると、ターン1の完了を待ってからターン2を起動します。依存しない調査を1つの応答にまとめると、待ち時間が重なりません。
解くための考え方
ログの調査とデプロイ履歴の調査は、互いの結果を必要としません。遅いのは、コーディネーターが一方を起動して結果を待ち、終わってからもう一方を起動しているためです。2つの Agent ツール呼び出しを1回の応答にそろえて出せば、ハーネスが同時に実行します。結果はこれまでどおりコーディネーターに戻り、原因をまとめる流れは残ります。
調査ごとにコーディネーターとサブエージェントの組を別スレッドで動かすと、同時には進みますが、1つのコーディネーターが両方を受け取ってまとめる流れがなくなります。1つのサブエージェントに両方を続けさせると、その中では順番に調べます。maxTurns を小さくしても、一方の完了を待ってから次を起動する順序は残ります。
参考資料
問題文:
シナリオ:Claudeによる開発者の生産性向上
あなたは、Claude Agent SDKを使用して開発者の生産性向上ツールを構築しています。このエージェントは、エンジニアが不慣れなコードベースを探索し、レガシーシステムを理解し、ボイラープレートコードを生成し、反復的なタスクを自動化するのを支援します。組み込みツール(Read、Write、Bash、Grep、Glob)を使用し、Model Context Protocol(MCP)サーバーと統合します。
ある開発チームは、本番リリースの準備をするときに、Claude Code と対話しながら9項目の確認リスト(データベースの移行、機能フラグ、ロールバック手順など)を1項目ずつ確かめています。今は開発者が準備のたびにリストを会話に貼り付けています。一方で、Claude Code は新機能の実装、障害の調査、ドキュメントの作成にも日常的に使われています。この作業に最も合う方法はどれですか。
選択肢:
A. 確認リストをスキルにまとめ、リリースの準備を始めるときに /release-check で呼び出します。
B. 確認リストを paths を指定しない .claude/rules/release.md に書き、プロジェクトの規約として読み込ませます。
C. 確認リストをシステムプロンプトに組み込んだリリース確認用のサブエージェントを定義し、準備のときに作業を任せます。
D. SessionStart フック(hooks)を設定し、セッションを開始するたびに確認リストを Claude のコンテキストに追加させます。
正解:A
A. 確認リストをスキルにまとめ、リリースの準備を始めるときに /release-check で呼び出します。
正解 スキルは、/スキル名 で必要なときにだけ呼び出せる手順です。準備のたびに貼り付ける手間がなくなり、名前で呼ばない作業では、確認リストが起動のたびに必ず入る仕組みではありません。
B. 確認リストを paths を指定しない .claude/rules/release.md に書き、プロジェクトの規約として読み込ませます。
不正解 paths を指定しないルールは、CLAUDE.md と同じく起動時に毎回読み込まれます。リリースの準備以外の作業でも確認リストがコンテキストに入るため、ほかの作業に影響します。
C. 確認リストをシステムプロンプトに組み込んだリリース確認用のサブエージェントを定義し、準備のときに作業を任せます。
不正解 サブエージェントは独立したコンテキストで作業し、結果だけを本会話に返します。開発者が Claude と対話しながら1項目ずつ確かめるという今の進め方を、本会話の中で続けられません。
D. SessionStart フック(hooks)を設定し、セッションを開始するたびに確認リストを Claude のコンテキストに追加させます。
不正解 SessionStart フックは、どの作業のセッションでも開始時に実行されます。新機能の実装や障害の調査のセッションにも確認リストが入り、リリースの準備と関係のない作業のコンテキストを占めます。
問われている要件
- 特定の作業のときだけ使う手順を、毎回貼り付けずに使える形にすること
- ほかの作業のコンテキストには手順を入れないこと
前提知識
スキルと CLAUDE.md の使い分けについて
- スキルは
.claude/skills/<スキル名>/SKILL.mdに手順を書き、/スキル名で必要なときだけ呼び出すワークフローです。その作業のときだけ使う手順に向いており、プロジェクト配下に置けばチームで共有できます - 以前のカスタムスラッシュコマンド(
.claude/commands/)も、現在はスキルと同じ仕組みとして扱われます -
CLAUDE.mdはセッションの開始時に毎回読み込まれます。どの作業でも守る共通の標準を書く場所です。ときどきしか使わない長い手順を置くと、関係のない作業のコンテキストを占めます
毎回読み込まれるルールと、セッション開始時の注入について
-
.claude/rules/のルールは、pathsを指定すると一致するファイルを読み書きするときに読み込まれます。pathsがないルールはCLAUDE.mdと同じく、起動のたびに読み込まれます -
SessionStartフックは、セッションの開始時にコマンドを実行し、その出力をコンテキストへ加えられます。作業の種類を区別しないので、どのセッションにも同じ内容が入ります
サブエージェントについて
- サブエージェントは別のコンテキストで作業し、メインの会話へ戻るのは最後の結果だけです。利用者が対話しながら手順を進める作業は、結果だけが戻る委任では本会話の中で続けられません
図による解説
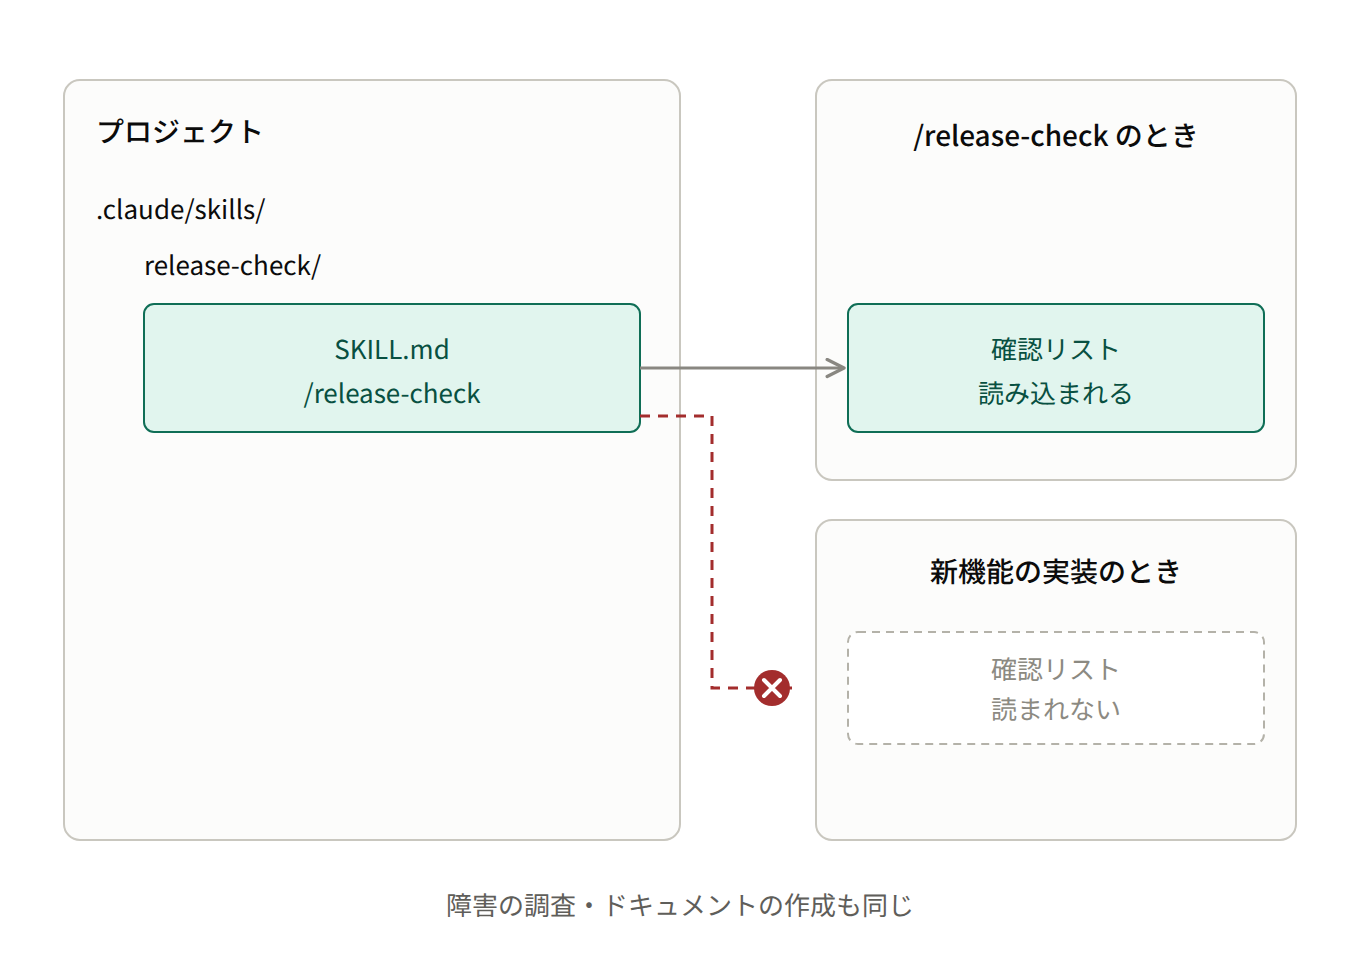
確認リストは /release-check を呼び出したときに読まれます。手順は .claude/skills/release-check/SKILL.md にあり、スキル名のスラッシュコマンドで開いたセッションが確認リストを読み込みます。新機能の実装では、名前で呼ばない限り、起動のたびに必ず入る仕組みではありません。障害の調査やドキュメントの作成でも同じです。
解くための考え方
確認リストが要るのは本番リリースの準備で9項目を1つずつ確かめるときだけで、新機能の実装、障害の調査、ドキュメントの作成では読む必要がありません。毎回読み込まれる CLAUDE.md ではなく、呼んだときだけ読むスキルにして、準備の開始時に /release-check で呼び出します。
リリース確認用のサブエージェントは、必要なときだけ動かせても、戻るのは結果だけなので、対話しながら1項目ずつ確かめる進め方を本会話では続けられません。SessionStart フックと、paths を指定しない .claude/rules/release.md は、作業の種類に関係なく確認リストを読み込みます。
参考資料
問題文:
シナリオ:Claudeによる開発者の生産性向上
あなたは、Claude Agent SDKを使用して開発者の生産性向上ツールを構築しています。このエージェントは、エンジニアが不慣れなコードベースを探索し、レガシーシステムを理解し、ボイラープレートコードを生成し、反復的なタスクを自動化するのを支援します。組み込みツール(Read、Write、Bash、Grep、Glob)を使用し、Model Context Protocol(MCP)サーバーと統合します。
ある開発チームでは、Claude Code で単体テストを実行するコマンドが決まっています。先輩がセッションを開くと、このリポジトリでも別のリポジトリでも、開いた直後からそのコマンドで単体テストが実行されます。スキルもスラッシュコマンドも呼んでいません。同じリポジトリをクローンした新しいメンバーがセッションを開いても、そのコマンドでは実行されません。新しいメンバーの /context では、Memory files に ./CLAUDE.md が出ています。この差が起きる原因として、最も適切なものはどれですか。
選択肢:
A. テストの実行コマンドは先輩の ./CLAUDE.local.md に書かれていて、そのファイルは gitignore されています。
B. テストの実行コマンドは先輩の ~/.claude/rules/ に書かれていて、そのルールには paths が付いています。
C. 新しいメンバーのユーザーレベルの設定が空で、/context に出ている ./CLAUDE.md の文を上書きして消しています。
D. テストの実行コマンドは先輩の ~/.claude/CLAUDE.md に書かれていて、このリポジトリのファイルには入っていません。
正解:D
A. テストの実行コマンドは先輩の ./CLAUDE.local.md に書かれていて、そのファイルは gitignore されています。
不正解 ./CLAUDE.local.md が読まれるのは、書いた本人の今のプロジェクトだけです。先輩が別のリポジトリを開いたセッションにはこのファイルが無いので、どのリポジトリでも同じコマンドになる事実とは合いません。
B. テストの実行コマンドは先輩の ~/.claude/rules/ に書かれていて、そのルールには paths が付いています。
不正解 paths が付いたルールは、一致するファイルを Read、Write、Edit したときに読まれます。セッションを開いた直後、ファイルを触る前からコマンドが効いている事実とは、読まれるタイミングが違います。
C. 新しいメンバーのユーザーレベルの設定が空で、/context に出ている ./CLAUDE.md の文を上書きして消しています。
不正解 見つかったメモリファイルは、上書きせずに連結されます。ユーザーレベルの設定が空でも、./CLAUDE.md に書いてある文は残ります。プロジェクトのファイルはクローンした相手にも届くので、先輩だけが別のリポジトリでも同じコマンドを使うことは、空のユーザーレベルの設定では説明できません。
D. テストの実行コマンドは先輩の ~/.claude/CLAUDE.md に書かれていて、このリポジトリのファイルには入っていません。
正解 ユーザーレベルの設定は、書いた本人のすべてのプロジェクトで、セッションの開始時に読まれます。バージョン管理では配られないので、クローンした相手のセッションには含まれません。どのリポジトリでも開いた直後からコマンドが効くことと、新しいメンバーには届かないことが、同時に説明できます。/context に出る ./CLAUDE.md は、両方の端末で読まれる別のファイルです。
問われている要件
- どのプロジェクトを開いても、セッション開始時から同じテストコマンドが効く置き場所であること
- リポジトリのクローンでは、そのコマンドが相手に渡らないこと
前提知識
CLAUDE.md の置き場所について
- ユーザーレベルは
~/.claude/CLAUDE.mdです。書いた本人のすべてのプロジェクトにだけ読まれ、バージョン管理ではほかの人に配られません - プロジェクトレベルは
./CLAUDE.mdまたは./.claude/CLAUDE.mdです。ソース管理を通じて、リポジトリを共有した人のセッションに届きます - ディレクトリレベルは、そのサブディレクトリ配下を扱うときの
CLAUDE.mdです。離れた場所に散らばったファイルを、一つのディレクトリレベルの指示だけでまとめて対象にすることはできません - ローカル指示は
./CLAUDE.local.mdです。自分だけ、今のプロジェクトだけに届き、gitignoreに追加します - 大きな指示を分けたいときは、
@importで必要な標準だけを取り込むか、.claude/rules/にトピック別のファイルを置きます
読み込まれるタイミングと連結について
-
CLAUDE.mdはセッションの開始時に読まれます。何が読まれたかは/contextを実行し、Memory files の一覧で確認します -
/memoryはメモリファイルの場所を一覧し、エディタで開くためのものです。読み込まれたかの確認には使いません - 見つかった
CLAUDE.mdとCLAUDE.local.mdは、互いに上書きせず、コンテキストに連結されます。空のユーザーレベルの設定が、プロジェクトのファイルに書いてある文を消すことはありません
パス固有のルールについて
-
pathsの無いルールは無条件に読まれます。paths付きのルールは、glob に一致するファイルをRead、Write、Editしたときに読まれます - プロジェクトのルールは、そのリポジトリの
.claude/rules/にあります。別のリポジトリを開いても、こちらのリポジトリのルールは読まれません - コードベースのあちこちに散らばった種類のファイルに規約を効かせるときは、サブディレクトリごとに
CLAUDE.mdを複製するより、パス固有のルールで glob を使います
図による解説
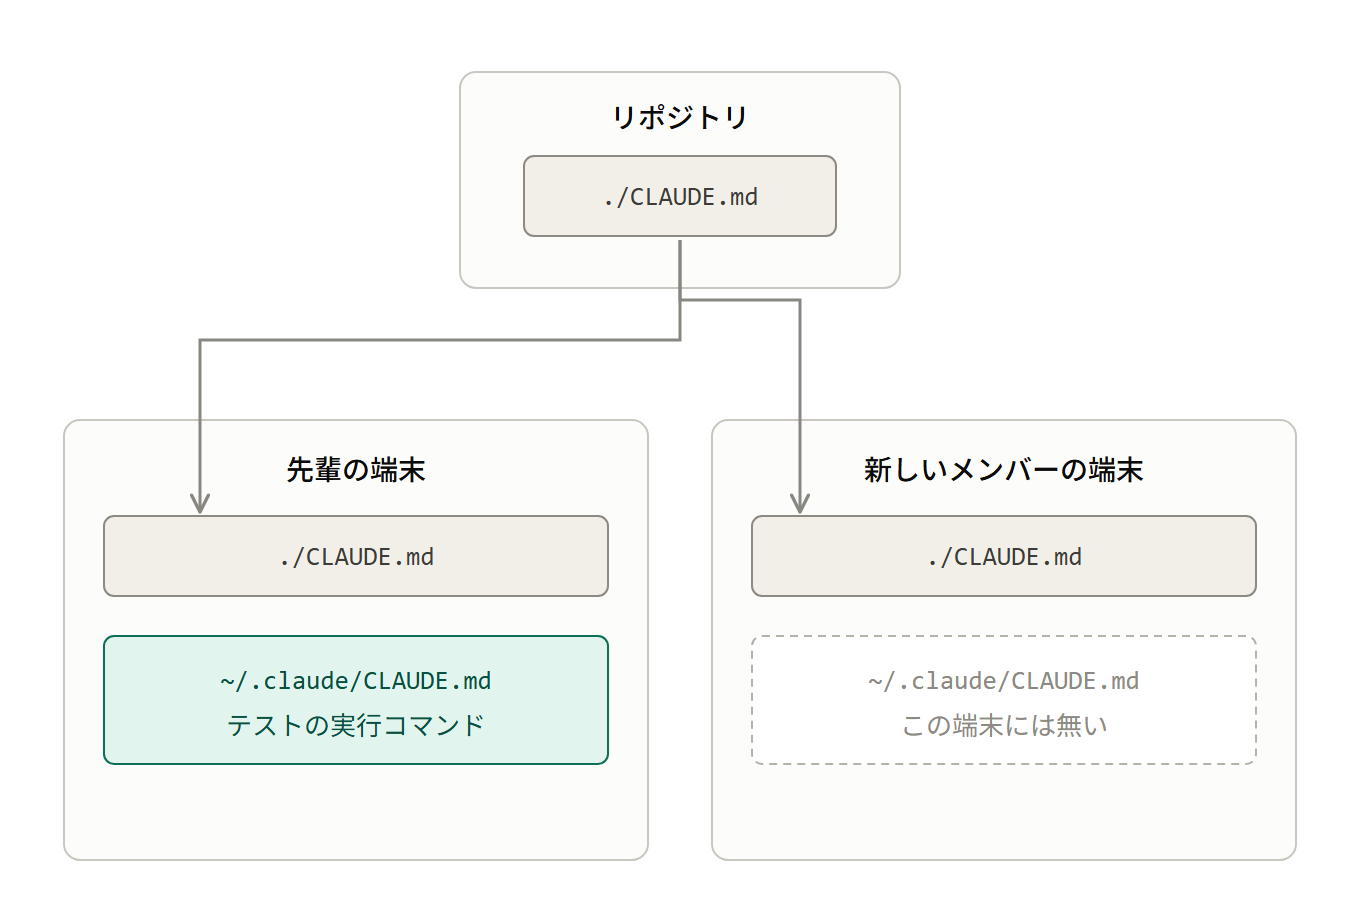
リポジトリの ./CLAUDE.md は、先輩の端末と新しいメンバーの端末の両方に届いています。テストの実行コマンドは、先輩の端末の ~/.claude/CLAUDE.md に書かれています。新しいメンバーの側は、この端末には無い、と示しています。クローンで渡るのは、リポジトリの ./CLAUDE.md です。
解くための考え方
先輩のセッションでは、リポジトリが違っても開いた直後から同じテストコマンドが実行され、スキルやスラッシュコマンドは使っていません。クローンした新しいメンバーではそのコマンドにならず、/context の Memory files には ./CLAUDE.md が出ているので、プロジェクトレベルの設定は読めている状態です。本人のすべてのプロジェクトに届き、バージョン管理では配られず、セッション開始時に読まれるのは ~/.claude/CLAUDE.md です。テストコマンドがそこにあれば、先輩のどのリポジトリでも開いた直後から効き、クローンした相手には届きません。
./CLAUDE.local.md は今のプロジェクトだけなので、先輩の別のリポジトリのセッションには入りません。paths 付きのルールは、一致するファイルを Read、Write、Edit して初めて読まれるので、ファイルを触る前のセッション開始時にはまだ会話に無い状態です。空のユーザーレベルの設定は ./CLAUDE.md を上書きせず、見つかったファイルは連結されたまま残ります。プロジェクトのファイルはクローンで相手にも届くので、先輩だけが別のリポジトリでも同じコマンドを使う理由にはなりません。
参考資料
問題文:
シナリオ:カスタマーサポート解決エージェント
あなたは、Claude Agent SDKを使用してカスタマーサポート解決エージェントを構築しています。このエージェントは、返品、請求に関する異議、アカウントの問題など、曖昧さの大きいリクエストを処理します。カスタムのModel Context Protocol(MCP)ツール(get_customer、lookup_order、process_refund、escalate_to_human)を通じて、バックエンドシステムにアクセスできます。目標は、エスカレーションすべきタイミングを見極めながら、初回対応での解決率80%以上を達成することです。
社内 IT ヘルプデスクのエージェントは、社員アカウントの操作をツール user_admin 1つで行い、action 引数で照会・権限付与・パスワード再設定・利用停止を切り替えています。操作によって使う引数が違うため、role や suspend_reason などの引数はすべて任意として定義しています。呼び出しのログを確認すると、role のない権限付与や、role を付けた利用停止の呼び出しが繰り返し見つかりました。この誤りを最も効果的に減らすツール定義の変更はどれですか。
選択肢:
A. ツールを操作の種類ごとに分け、それぞれのスキーマにはその操作で使う引数だけを定義して、必要な引数を required にします。
B. ツールは1つにまとめたまま、action の引数を enum で定義し、照会・権限付与・パスワード再設定・利用停止の4つの値だけを受け付けるようにします。
C. ツールを参照用と変更用の2つに分け、変更用のツールでは action の値によって権限付与・再設定・利用停止を切り替えます。
D. ツールは1つにまとめたまま、ツール定義に strict: true を指定し、スキーマに沿った引数だけが生成されるようにします。
正解:A
A. ツールを操作の種類ごとに分け、それぞれのスキーマにはその操作で使う引数だけを定義して、必要な引数を required にします。
正解 操作ごとにツールを分けると、各スキーマにはその操作の引数だけが並び、渡すべき引数が required として直接示されます。どの引数が必要で、どれが関係ないのかに迷う余地がなくなるため、引数の不足や余計な指定が減ります。
B. ツールは1つにまとめたまま、action の引数を enum で定義し、照会・権限付与・パスワード再設定・利用停止の4つの値だけを受け付けるようにします。
不正解 enum は、引数が取れる値を列挙した候補に限る指定です。action に想定外の値が入る誤りは防げますが、ログで見つかっているのは操作名の誤りではなく、role の欠落や余計な付与です。role や suspend_reason がすべて任意のままなので、この誤りは減りません。
C. ツールを参照用と変更用の2つに分け、変更用のツールでは action の値によって権限付与・再設定・利用停止を切り替えます。
不正解 照会だけを別のツールに切り出すと、誤りが起きている権限付与と利用停止は同じ変更用のツールに残ります。そのツールでは操作ごとに要る引数が違うのにどれも任意なので、role のない権限付与も、role を付けた利用停止も、これまでどおり呼び出せます。
D. ツールは1つにまとめたまま、ツール定義に strict: true を指定し、スキーマに沿った引数だけが生成されるようにします。
不正解 strict: true は、生成される引数をスキーマに厳密に従わせる設定です。このツールのスキーマでは操作ごとの引数がすべて任意なので、role のない権限付与もスキーマには沿っています。スキーマが操作ごとの必須項目を表していない限り、誤りは減りません。
問われている要件
- 操作ごとに必要な引数が異なるツールで、引数の過不足を減らすこと
- その操作で必須の引数を、スキーマの
requiredで表せること
前提知識
ツールの説明と入出力の契約について
- モデルはツールを呼び出すとき、名前、説明、
input_schemaを手がかりに引数を組み立てます。何をするツールか、いつ使うか、各引数が何を意味するかを説明に書くことが、ツール選択の性能に最も効きます -
requiredに並んだ引数は、必ず渡すものとしてスキーマから直接読めます。操作ごとに必須の引数が違うのに1つのスキーマへまとめると、引数をすべて任意にするか、条件付きの複雑な構造にするしかありません - 汎用的なツールを、入出力の契約がある目的別のツールへ分割すると、各スキーマにはその操作の引数だけが残ります。たとえば文書を扱う汎用ツールを、データの抽出、要約、情報源との照合のように分けます
操作を1つのツールにまとめるときの限界について
- 関連する操作を、操作の種類を表す引数で少数のツールにまとめると、ツールの数は減ります。必須の引数が違う操作を同じスキーマに残すと、欠けた引数も余計な引数もスキーマ上は通ります
- 参照と更新のように粗く分けるだけでは、必須の引数が違う操作が同じ側に残ることがあります。分ける単位は、操作ごとの入出力の違いに合わせます
enum と strict について
- JSON Schema の
enumは、その引数が取れる値を列挙した候補に限ります。操作名の取り違えは防げますが、別の引数を必須にはできません - ツール定義の
strict: trueは、生成される引数をスキーマに厳密に従わせます。守らせられるのはスキーマに書いた制約までです。スキーマが引数を任意としている操作では、その引数が欠けた呼び出しもスキーマに沿います
図による解説
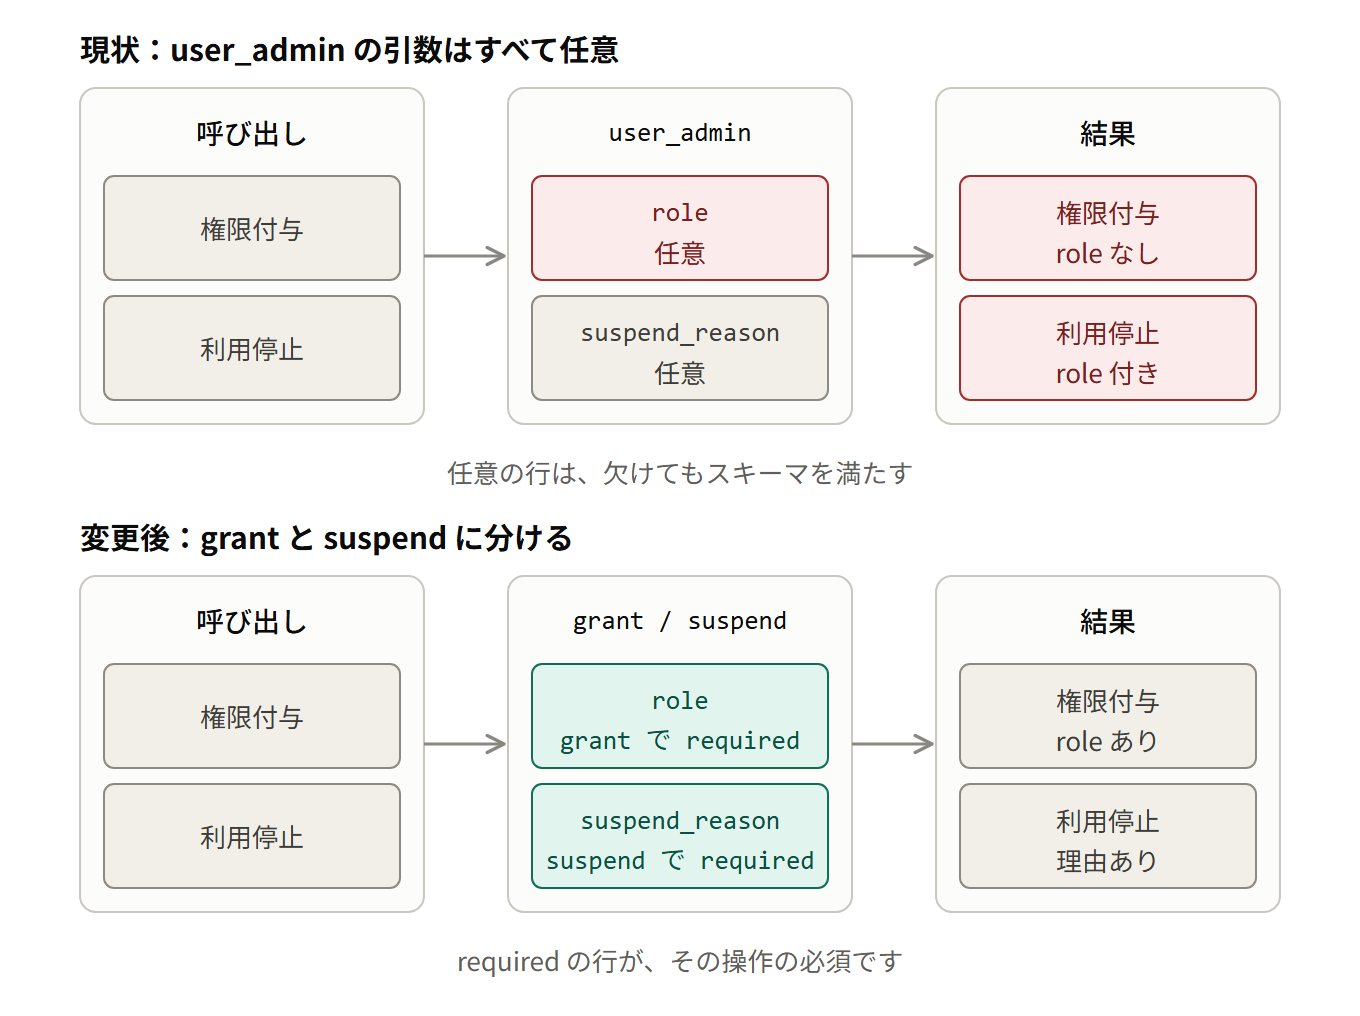
操作ごとにツールを分けると、その操作に必要な引数が required で示されます。1つの user_admin にまとめると role も suspend_reason も任意のままなので、権限付与で role が欠けても、利用停止で role が付いていても、スキーマは通ります。grant と suspend に分けると、権限付与では role が、利用停止では suspend_reason が required になります。分かれたスキーマでは、その操作に要る引数だけが required として読めます。
解くための考え方
role が欠ける権限付与や、role を付けた利用停止が起きるのは、user_admin の引数が操作ごとに違うのにすべて任意だからです。操作ごとの必須の引数がスキーマに表れていないことが誤りの原因なので、操作ごとにツールを分けて required で示す対策が合います。
参照用と変更用に分ける方法では、誤りが起きている権限付与と利用停止が同じ変更用のツールに残ります。action を enum にする方法は操作名の取り違えを防ぐだけで、strict: true はスキーマに書いてある制約へ従わせるだけです。任意のままの引数は、どちらでも必須になりません。
参考資料
問題文:
シナリオ:カスタマーサポート解決エージェント
あなたは、Claude Agent SDKを使用してカスタマーサポート解決エージェントを構築しています。このエージェントは、返品、請求に関する異議、アカウントの問題など、曖昧さの大きいリクエストを処理します。カスタムのModel Context Protocol(MCP)ツール(get_customer、lookup_order、process_refund、escalate_to_human)を通じて、バックエンドシステムにアクセスできます。目標は、エスカレーションすべきタイミングを見極めながら、初回対応での解決率80%以上を達成することです。
通信会社のサポートエージェントは、waive_fee ツールで解約金を免除します。規程により、免除額が 1 万円を超える案件はモデルの判断に任せず、人間の担当者へエスカレーションする必要があります。システムプロンプトに明確に書いていますが、ログでは約 2% の案件でエージェントが直接免除していました。規程を確実に守らせる方法はどれですか。
選択肢:
A. PreToolUse フック(hooks)で waive_fee の呼び出しを検査し、1 万円を超える免除は実行を拒否してエスカレーションを起動します。
B. waive_fee の中で免除額を確認し、1 万円を超えていれば処理を行わずにエラーを返して、本文で「担当者へのエスカレーションが必要です」と伝えます。
C. tool_choice で check_policy ツールを指定し、waive_fee を呼ぶ前に、免除額が規程に合うかの確認を毎回必ず行わせます。
D. waive_fee のツールの説明に「免除額が 1 万円を超える案件には使わず、人間の担当者にエスカレーションすること」と、使わない場合を明記します。
正解:A
A. PreToolUse フック(hooks)で waive_fee の呼び出しを検査し、1 万円を超える免除は実行を拒否してエスカレーションを起動します。
正解 PreToolUse フックはツールの実行前に必ず動くプログラムで、条件に合う呼び出しを拒否できます。免除額の検査とエスカレーションの起動をプログラムで行うため、モデルがどう判断しても 1 万円を超える免除は実行されず、エスカレーションも確実に行われます。
B. waive_fee の中で免除額を確認し、1 万円を超えていれば処理を行わずにエラーを返して、本文で「担当者へのエスカレーションが必要です」と伝えます。
不正解 ツールの中での検査は、免除の実行を止める仕組みとしては確実です。足りないのは、エスカレーションの起動まで確実に行うという2つ目の要件で、エスカレーションを行うかどうかは、エラー文を読んだエージェントの判断に残ります。エージェントがエスカレーションせずに別の対応を続ければ規程は守られないため、確実な方法にはなりません。
C. tool_choice で check_policy ツールを指定し、waive_fee を呼ぶ前に、免除額が規程に合うかの確認を毎回必ず行わせます。
不正解 tool_choice で強制できるのは、そのターンで指定したツールを呼ぶことだけです。確認の結果を受けて waive_fee を呼ぶかエスカレーションするかは引き続きモデルが決めるため、直接の免除を止める仕組みにはなりません。
D. waive_fee のツールの説明に「免除額が 1 万円を超える案件には使わず、人間の担当者にエスカレーションすること」と、使わない場合を明記します。
不正解 ツールの説明は、モデルがツールを選ぶときの手がかりです。書く場所がシステムプロンプトからツールの説明に移っても、従うかどうかはモデルの判断に依存するため、約 2% の直接免除を確実になくすことはできません。
問われている要件
- モデルの判断に任せられない規程を、確実に守らせること
- 1 万円を超える免除を止め、人間の担当者へエスカレーションすること
前提知識
実行前のフックについて
- PreToolUse はツールを実行する前に呼び出しを受け取るフックです。条件に合う呼び出しは権限の決定で拒否するか、終了コード 2 でブロックします。この拒否は
bypassPermissionsでも有効です - 一定額を超える返金のように、規則に反する操作を API に出さず、人間の担当者へのエスカレーションに切り替えるときに使います
- ビジネスルールを必ず守らせるときは、プロンプトベースのガイダンスではなくプログラムによる強制(フック)を選びます。フックはモデルが実行を選ぶかどうかに依存しません
実行後のフックと、指示による強制について
- PostToolUse はツールが成功したあと、モデルが結果を読む前に動きます。異なるツールが返す時刻の形式や状態コードをそろえる役で、実行そのものは止めません
- システムプロンプト、ツールの説明、few-shot の例は、従う割合を上げます。従わなかった回の操作はそのまま実行されます
-
tool_choiceで指定したツールを、そのターンで必ず呼ばせることはできます。その結果を見て次に何をするかは、モデルの判断に残ります
図による解説
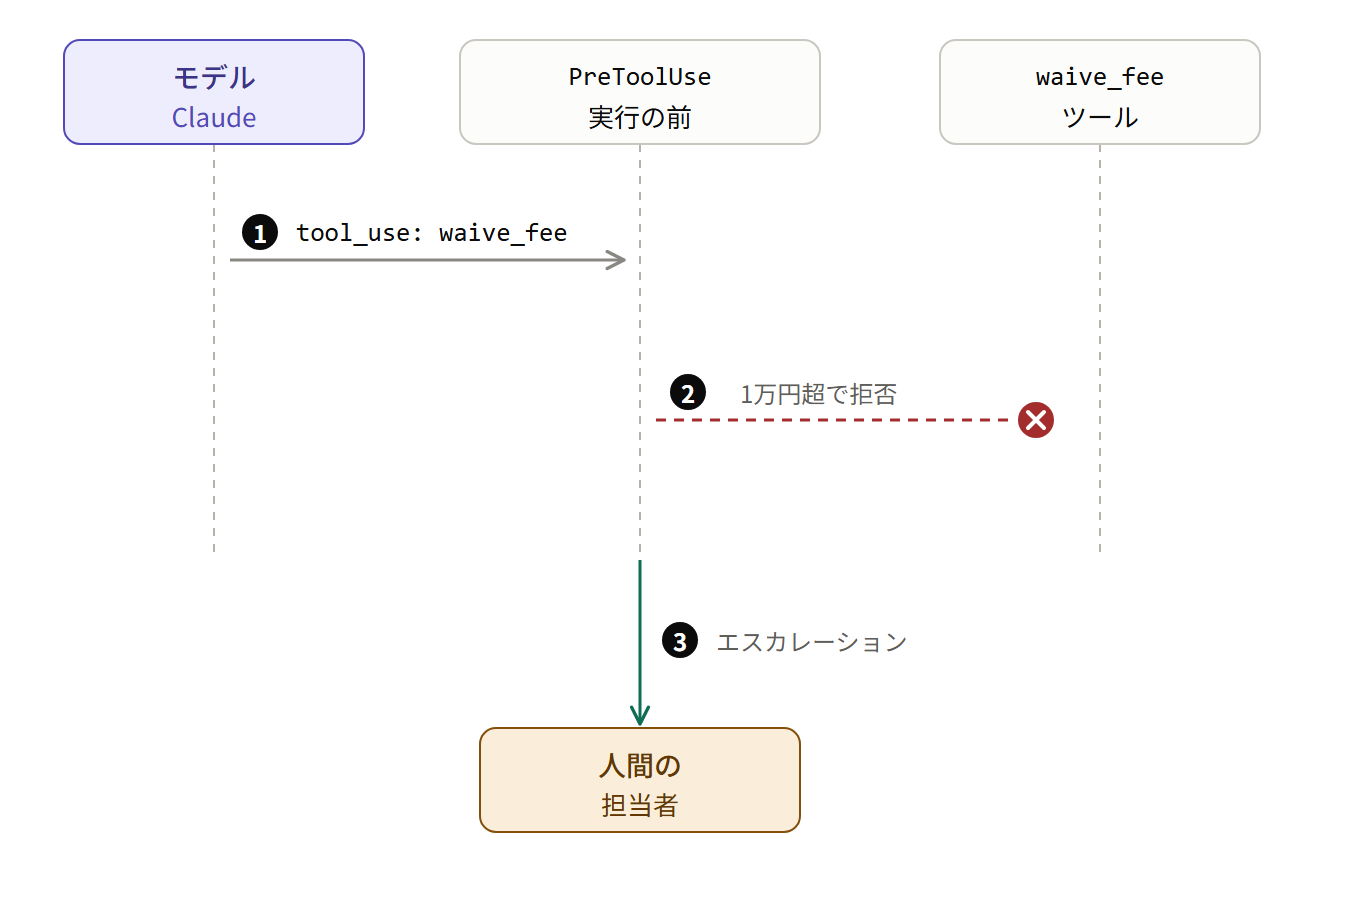
1万円を超える waive_fee は、実行前の PreToolUse が止めて人間の担当者へエスカレーションします(①〜③)。①の tool_use: waive_fee は、ツールが動く前にフックへ届きます。②では金額が1万円を超えているため拒否され、waive_fee 自体は実行されません。③でその呼び出しを人間の担当者へ渡すので、手数料の免除は人の判断を待ちます。
解くための考え方
規程をシステムプロンプトに書いていても、約2%の案件で直接免除しています。金額で必ず止める規則はモデルが従うかどうかに任せられません。実行前のフックはツールが動く前に必ず検査し、条件に合う呼び出しを拒否できます。拒否に続けてエスカレーションを起動すれば、免除を止めることと、人に渡すことの両方がプログラムでそろいます。
ツールがエラーを返す方法は、免除の実行は止められます。エスカレーションを起動するかどうかはエラーを読んだモデルに残ります。ツールの中で承認依頼まで作るなら起動までプログラムで行えますが、エラーの本文で伝えるだけでは起動しません。指定した確認ツールをそのターンで必ず呼ばせても、その後に免除するかはモデルが決めます。説明に禁止を書いても、書く場所がプロンプトから説明に移るだけで、従う割合が上がるだけです。
参考資料
問題文:
シナリオ:カスタマーサポート解決エージェント
あなたは、Claude Agent SDKを使用してカスタマーサポート解決エージェントを構築しています。このエージェントは、返品、請求に関する異議、アカウントの問題など、曖昧さの大きいリクエストを処理します。カスタムのModel Context Protocol(MCP)ツール(get_customer、lookup_order、process_refund、escalate_to_human)を通じて、バックエンドシステムにアクセスできます。目標は、エスカレーションすべきタイミングを見極めながら、初回対応での解決率80%以上を達成することです。
ある企業が、社内のサポート業務を手伝うエージェントを Claude Agent SDK で作っています。エージェントには、顧客管理、請求、メール送信を扱う3つの MCP サーバーを設定しました。担当者から「契約内容を確認してから今月の請求書を再発行し、顧客にメールで送ってほしい」という依頼が届きました。この依頼を処理するとき、エージェントは3つのサーバーのツールをどのように使いますか。
選択肢:
A. ツールを呼び出すたびに、エージェントが3つのサーバーへ順番に問い合わせて、そのツールを持つサーバーを確かめてから呼び出します。
B. エージェントは MCP サーバーのツールを直接は呼び出せず、agents で定義したサブエージェント(subagent)の tools にそのツールを指定して、その経由で呼び出します。
C. 設定した3つのサーバーのツールが、接続した時点からどれも同時に使える状態になり、1つの依頼の中で組み合わせて呼び出せます。
D. ツール検索が働くと、エージェントは依頼ごとに1つのサーバーのツール定義だけを読み込み、そのほかのサーバーのツールは、その依頼の間は呼び出せません。
正解:C
A. ツールを呼び出すたびに、エージェントが3つのサーバーへ順番に問い合わせて、そのツールを持つサーバーを確かめてから呼び出します。
不正解 どのサーバーがどのツールを提供するかは、接続したときに各サーバーから取得されます。ツール名にサーバー名が含まれているので、呼び出しのたびに各サーバーへ問い合わせて持ち主を探すことはありません。
B. エージェントは MCP サーバーのツールを直接は呼び出せず、agents で定義したサブエージェント(subagent)の tools にそのツールを指定して、その経由で呼び出します。
不正解 サブエージェントは、役割を分けたいときに開発者が定義して使うもので、MCP サーバーのツールを呼ぶための必須の経路ではありません。設定したサーバーのツールは、メインのエージェントが直接呼び出せます。
C. 設定した3つのサーバーのツールが、接続した時点からどれも同時に使える状態になり、1つの依頼の中で組み合わせて呼び出せます。
正解 Agent SDK はセッションの開始時に、設定したすべての MCP サーバーへ接続します。各サーバーのツールは mcp__<サーバー名>__<ツール名> という名前で並んで使えるため、顧客管理・請求・メール送信のツールを1つの依頼の中で順に呼び出せます。
D. ツール検索が働くと、エージェントは依頼ごとに1つのサーバーのツール定義だけを読み込み、そのほかのサーバーのツールは、その依頼の間は呼び出せません。
不正解 ツール検索(tool search)は、ツール定義をコンテキストに置く時期を調整する機能で、読み込むツールはサーバーを区別せず、その場面で必要なものが選ばれます。1つの依頼の中で、複数のサーバーのツールが使われます。
問われている要件
- 設定した複数の MCP サーバーのツールを、1つの依頼の中で組み合わせて呼べること
- どのサーバーのツールかは、接続したときに得た一覧で分かること
前提知識
接続時に揃うツールについて
- 複数の MCP サーバーを設定すると、セッションの開始時に設定したすべてのサーバーに接続し、各サーバーが公開するツールの一覧を取得します
- 取得したツールは
mcp__<サーバー名>__<ツール名>という名前で同時に使え、どのサーバーのツールかは名前で区別されます - どのツールをどの順で呼ぶかは、モデルが名前と説明から判断します。1つの依頼の中で、別々のサーバーのツールを組み合わせて呼べます
- 一覧は接続時に取得するので、呼び出しのたびに各サーバーに持ち主を問い合わせる必要はありません
ツール検索、サブエージェント、リソースについて
- ツール検索は、ツール定義をコンテキストに置く時期を調整します。読み込む定義はサーバー単位で1つに絞られず、必要なものが選ばれます。複数サーバーのツールを1つの依頼で使えます
- サブエージェントは、役割を分けたいときに定義するもので、MCP のツールを呼ぶ必須の経路ではありません。設定したサーバーのツールは、メインのエージェントが直接呼べます
- 何があるかの一覧を、操作とは別に MCP のリソースとして公開すると、中身を探すための試し呼び出しを減らせます。リソースはカタログであり、ツールを同時に呼べるようにする仕組みではありません
図による解説
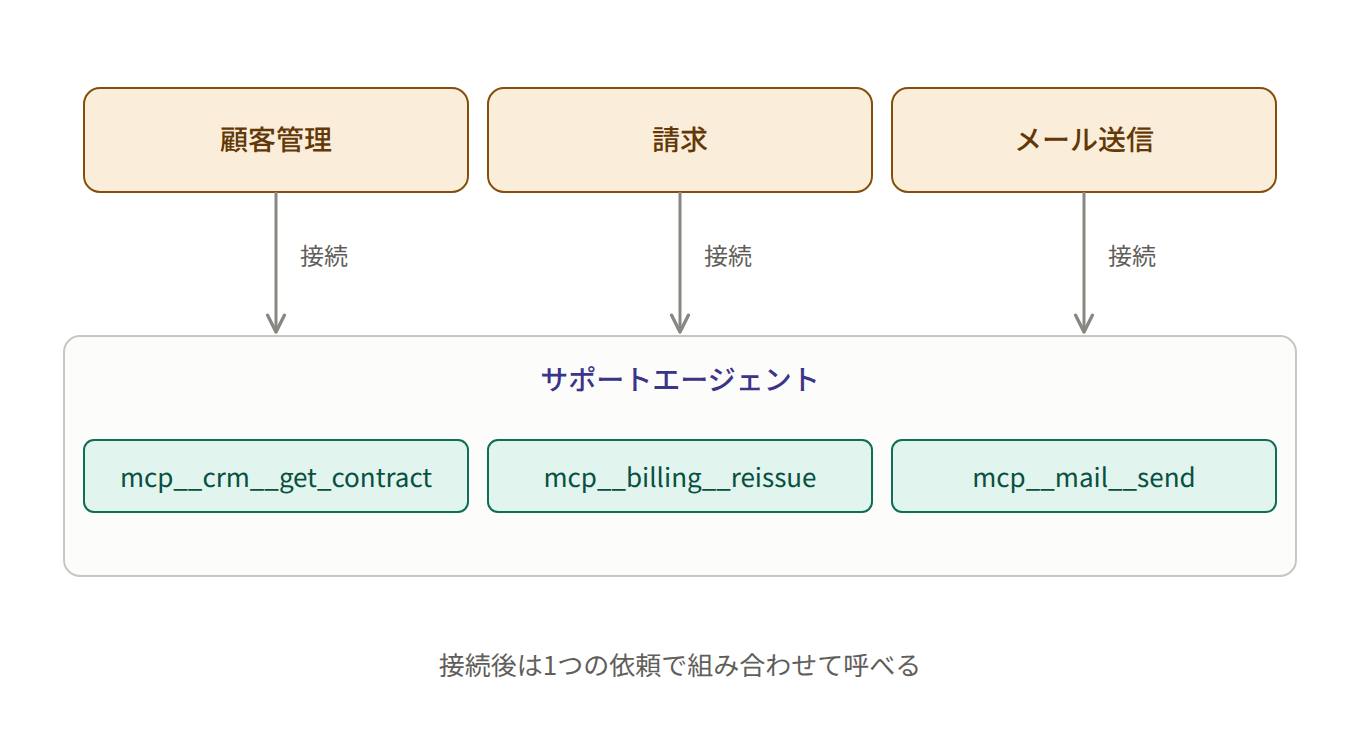
Agent SDK はセッションの開始時に、設定したすべての MCP サーバーへ接続し、各サーバーのツールを mcp__<サーバー名>__<ツール名> という名前でエージェントに渡します。顧客管理は mcp__crm__get_contract、請求は mcp__billing__reissue、メール送信は mcp__mail__send として、サポートエージェントから区別できます。名前にサーバー名が入るので、1つの依頼の中で契約の確認、再発行、送信を組み合わせて呼べます。呼び出しのたびにサーバーを探し直す必要はありません。
解くための考え方
契約の確認、請求書の再発行、メール送信は、1つの依頼にまとまっています。セッションの開始時に設定したサーバーすべてに接続し、各サーバーのツール一覧を取得すると、ツールはサーバー名を含む名前で同時に並びます。1つの依頼の中で順に呼び出せて、どの順で呼ぶかは名前と説明からモデルが判断します。
呼び出しのたびに各サーバーに持ち主を問い合わせる必要はありません。一覧は接続時に取得済みです。サブエージェントのツール一覧を経由しなくても、メインのエージェントが MCP のツールを直接呼べます。ツール検索は定義をコンテキストに載せる時期を遅らせる機能で、依頼ごとに1つのサーバーに限定しません。
参考資料
問題文:
シナリオ:カスタマーサポート解決エージェント
あなたは、Claude Agent SDKを使用してカスタマーサポート解決エージェントを構築しています。このエージェントは、返品、請求に関する異議、アカウントの問題など、曖昧さの大きいリクエストを処理します。カスタムのModel Context Protocol(MCP)ツール(get_customer、lookup_order、process_refund、escalate_to_human)を通じて、バックエンドシステムにアクセスできます。目標は、エスカレーションすべきタイミングを見極めながら、初回対応での解決率80%以上を達成することです。
コンテキストの上限が近づいているチャットで、サポートエージェントが4件の依頼(配送遅延の補償、住所の変更、ポイントの失効、請求書の再発行)を順に処理しました。補償のクーポンの額と有効期限は、この会話の中で顧客と取り決めただけで、まだどのシステムにも登録していません。終盤に顧客がその条件を確かめてくるため、額と有効期限は取り決めたとおり、一字も違えずに答える必要があります。セッションの最後まで、どの件にも正確に答え続けられる設計はどれですか。
選択肢:
A. これまでの会話履歴を Files API でアップロードし、毎回のリクエストではファイル ID で参照させて送る量を減らします。
B. 件ごとに確定した事実を構造化した記録として会話履歴の外に保持し、各リクエストにその記録を含めて送ります。
C. 会話が長くなったら、コンパクション(compaction)で古いやり取りを自動的に要約へ置き換え、続きに使える余地を作ります。
D. 顧客が前の件に触れたときは、MCP ツールで注文や会員のシステムから該当する情報を取り直し、その結果で答えさせます。
正解:B
A. これまでの会話履歴を Files API でアップロードし、毎回のリクエストではファイル ID で参照させて送る量を減らします。
不正解 Files API は、ファイルを一度アップロードして、以後のリクエストで ID により参照できるようにする仕組みです。参照したファイルの内容は入力としてモデルに渡るため、コンテキストに入る量は減らず、上限に迫る問題は解決しません。
B. 件ごとに確定した事実を構造化した記録として会話履歴の外に保持し、各リクエストにその記録を含めて送ります。
正解 件ごとの事実を構造化して履歴の外に持てば、古いやり取りを圧縮したり削ったりしても、クーポンの額や有効期限のような値は失われません。会話の中だけで決まった補償の条件も記録に残るため、終盤に聞かれても正確に答えられます。
C. 会話が長くなったら、コンパクション(compaction)で古いやり取りを自動的に要約へ置き換え、続きに使える余地を作ります。
不正解 コンパクションは、古いやり取りを要約に置き換えてコンテキストを空ける仕組みです。要約はモデルが書き直した文章なので、クーポンの額や有効期限が省かれたり言い換えられたりすることがあり、一字も違えずに答えられる保証がありません。
D. 顧客が前の件に触れたときは、MCP ツールで注文や会員のシステムから該当する情報を取り直し、その結果で答えさせます。
不正解 必要なときにツールで情報を取り直す方法です。補償の条件は会話の中で取り決めたもので、まだどのシステムにも登録されていないため、ツールで取り直すことができません。
問われている要件
- 長いセッションで、コンテキストの上限に迫っても過去の件に正確に答えること
- 会話の中だけで決まった値を含め、正確な値を失わないこと
前提知識
ケースの事実情報ブロックについて
- 金額、日付、番号、状態のように、一字の違いが結果を変える値は、ケースの事実情報ブロックとして会話の要約とは別に構造化して保持し、各プロンプトに含めます。要約してよいのは経緯であり、事実の値そのものではありません
- 段階的な要約は、数値、割合、日付、相手が述べた期待を曖昧な文章に圧縮しやすい処理です。経緯を短くすることと、値を元のまま残すことは分けて設計します
- 会話の中だけで取り決めた値は、外部のシステムを照会しても戻りません。ツールで取り直せるのは、すでにシステムに記録された情報です
コンテキストを空ける処理の限界について
- コンパクションは、古いやり取りを要約に置き換えてコンテキストを空けます。モデルが書き直した文章では、数値が省かれたり言い換えられたりして、元の値と一致しなくなります
- ファイルをアップロードして ID で参照する仕組みは、受け渡しを効率化するだけで、参照した中身はモデルへの入力に入ります。履歴をファイルに移しても、読ませる限りコンテキストの使用量は減りません
図による解説
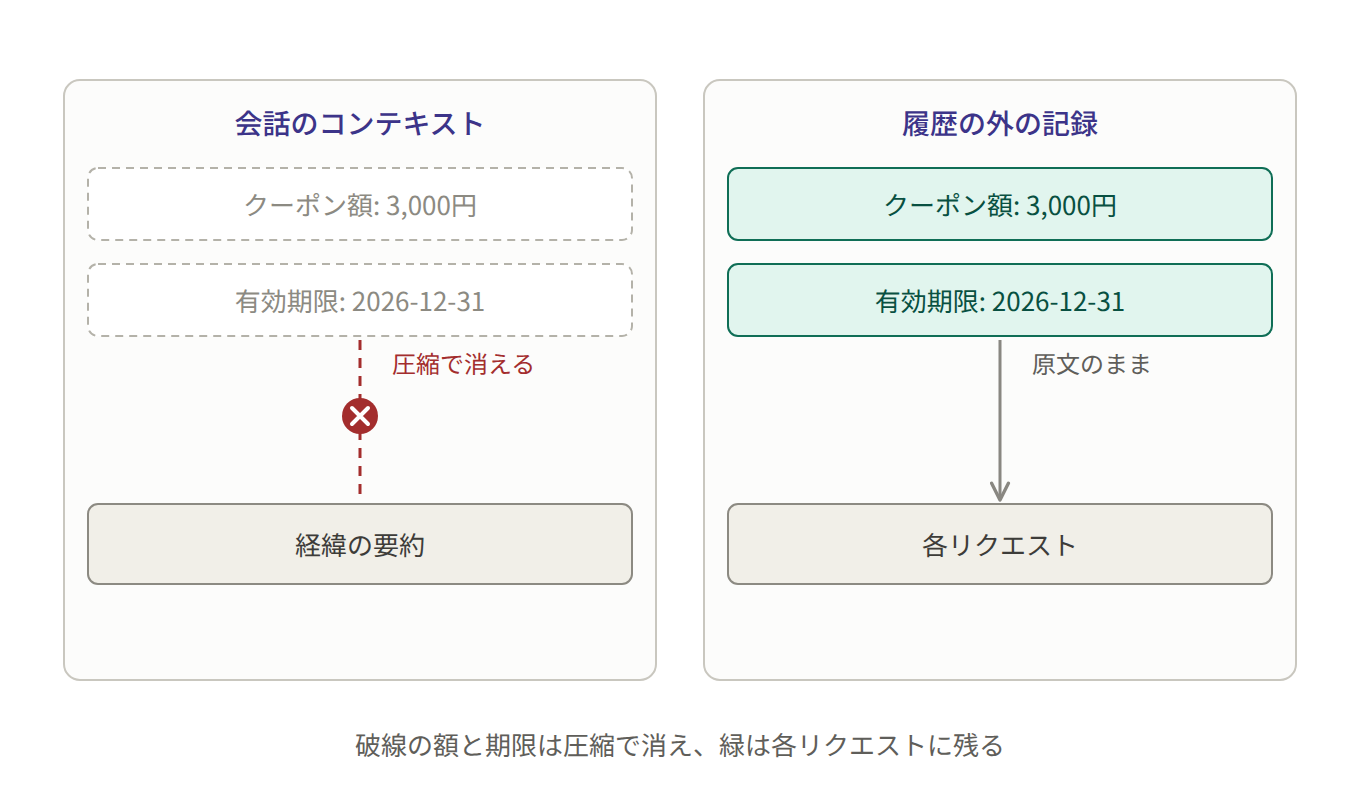
履歴の外の記録に置いた額と期限は、圧縮しても原文のまま残ります。会話の中にあるクーポン額 3,000円と有効期限 2026-12-31 は、経緯の要約に変わるとき消えます。同じ額と期限を履歴の外の記録に置くと、各リクエストへ原文のまま入ります。圧縮される会話と、毎回転送する記録とを分けると、金額と日付が要約で丸まりません。
解くための考え方
終盤に確かめられる額と有効期限は、この会話の中で取り決めただけで、まだどのシステムにもありません。上限が近づけば古いやり取りは圧縮する必要がありますが、圧縮した文章から元の数値を復元する保証はありません。件ごとに確定した事実を履歴の外に構造化して置き、各リクエストにその記録を含めれば、経緯を短くしても値は元のまま届きます。
システムに無い値は、注文や会員情報をツールで取り直しても戻ってきません。古いやり取りを要約に置き換える処理は、額や期限を省いたり言い換えたりします。履歴をファイルの ID で参照しても、読ませる中身はコンテキストに入るので、上限に迫っている状況は残ります。
参考資料
問題文:
シナリオ:構造化データ抽出
あなたは、Claudeを使用して構造化データ抽出システムを構築しています。このシステムは、非構造化ドキュメントから情報を抽出し、JavaScript Object Notation(JSON)スキーマを使用して出力を検証し、高い精度を維持します。エッジケースを適切に処理し、下流のシステムと統合する必要があります。
物件の紹介では、不動産の物件紹介文から、築年数・最寄り駅・駐車場の台数・管理費を Claude で抽出しています。JSON スキーマでは、どの欄も null を取れるようにしてあります。評価すると、駐車場について何も書かれていない紹介文で "parking_spaces": 1 が出力されるなど、記載のない欄にもっともらしい値が入る誤りが目立ちました。こうした誤った値を減らす方法として、最も効果的なものはどれですか。
選択肢:
A. プロンプトの冒頭に「この抽出では正確さが何よりも重要です」と書き、誤った値を出さないように強調します。
B. スキーマのすべての欄を null を取れない必須の欄に変え、検証を厳しくして、確かな値だけが出力されるようにします。
C. 紹介文にはっきり書かれていない欄は、値を推測せずに null を返すよう、プロンプトに指示を書き加えます。
D. 各欄に値の確信度を表す confidence の欄を加え、記載のない値には低い確信度を付けて出力させます。
正解:C
A. プロンプトの冒頭に「この抽出では正確さが何よりも重要です」と書き、誤った値を出さないように強調します。
不正解 正確さを強調しても、記載のない欄に何を返せばよいかという条件は示されていません。null を返す場面が定まらないままなので、記載のない欄を推測で埋める誤りは残ります。
B. スキーマのすべての欄を null を取れない必須の欄に変え、検証を厳しくして、確かな値だけが出力されるようにします。
不正解 欄を必須にすると、記載がない場合でも何かの値を入れなければスキーマを満たせなくなります。モデルは値を埋めるしかなくなり、書かれていない値を作る誤りはかえって増えます。
C. 紹介文にはっきり書かれていない欄は、値を推測せずに null を返すよう、プロンプトに指示を書き加えます。
正解 スキーマにはすでに null を返す余地がありますが、モデルはどの場合に使うのかを知らされていません。記載がなければ null にするという条件を明示すると、今のスキーマのまま、書かれていない値を作る誤りを直接減らせます。
D. 各欄に値の確信度を表す confidence の欄を加え、記載のない値には低い確信度を付けて出力させます。
不正解 確信度を添えても、値そのものは出力されたまま残ります。記載がないときにどうするかの基準は伝わらず、もっともらしい値を作る誤りは減りません。
問われている要件
- 文書に記載のない欄に、もっともらしい値が作られる誤りを減らすこと
- スキーマにある
nullの余地を、モデルに正しく使わせること
前提知識
null を許す欄について
- 情報源に無いことがある欄は、スキーマで
nullを許すか、省略できるようにします。必須でnullを許さない欄は、スキーマを満たすために何らかの値を入れるしかなく、文書に無い値を作る方向に働きます - 構造化出力が保証するのは欄の型と必須の欄であり、その値が文書に書いてあったことまでは保証しません。
nullを許すスキーマは、空で返す余地を作るだけです
記載が無いときの指示について
- 余地があっても、どの場合に
nullを返すかを書かないと、モデルは前後の文脈からそれらしい値で欄を埋めます。条件と返す値をセットで書きます。本文に明記されていない欄は推測せずnullにする、という指示です - 正確さが重要だという強調だけでは、記載が無いときに何を返すかが決まりません
- 確信度の欄を足しても、作られた値は出力に残ったままです。確信度で付けられるのは、確認の順番までです
図による解説
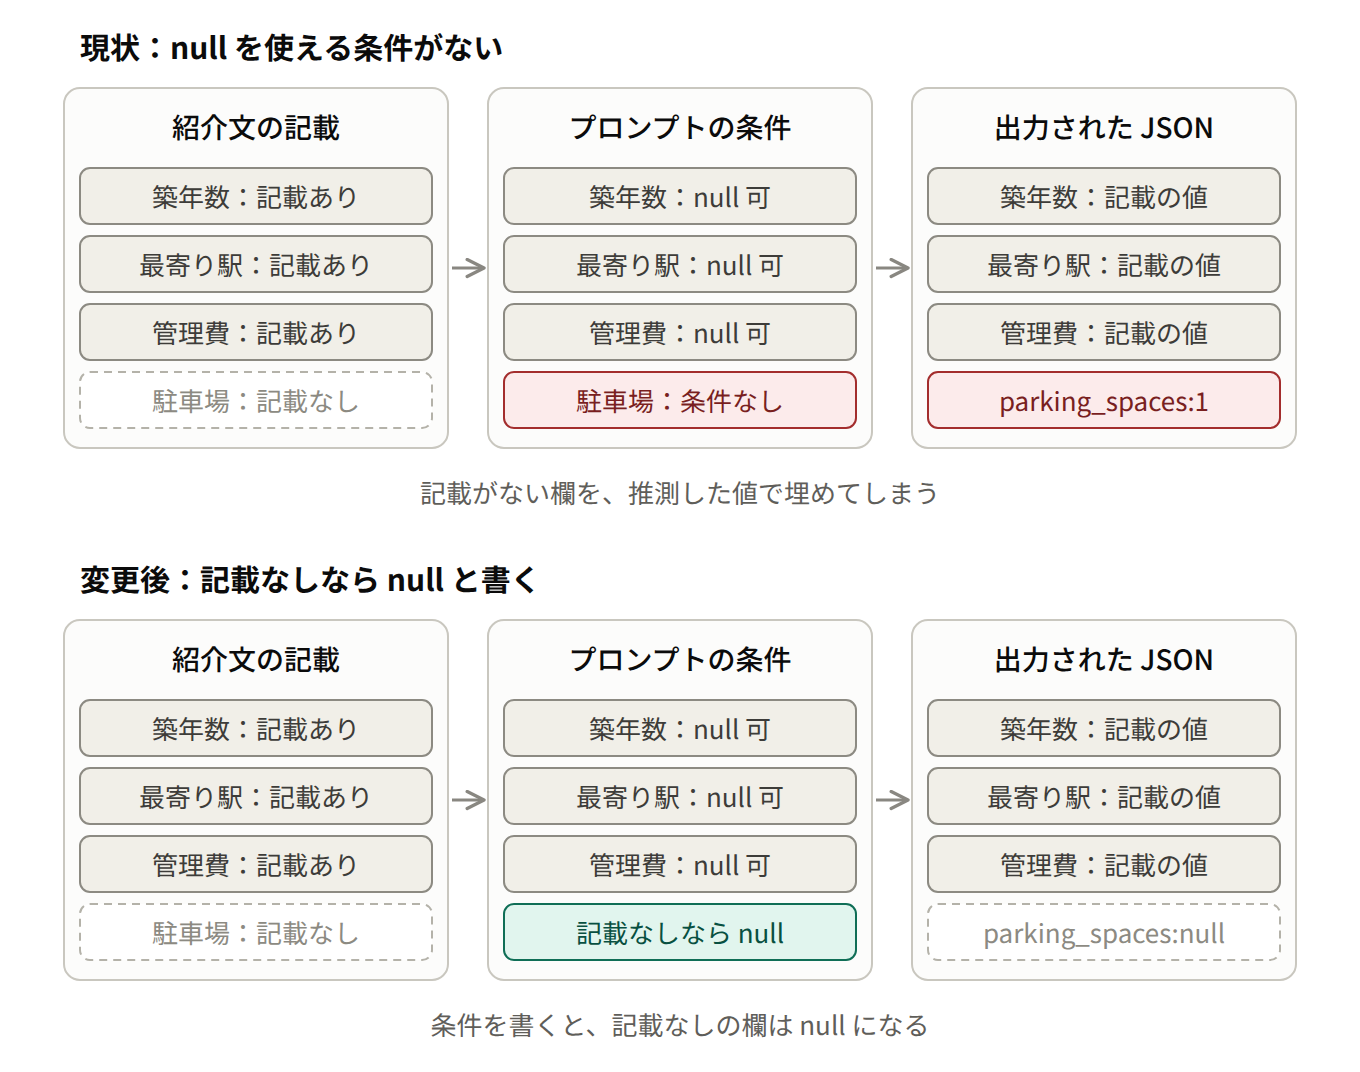
スキーマはどの欄も null を許せますが、記載が無ければ null にする条件を書かないと、モデルは記載の無い欄を推測で作ります。紹介文に築年数・最寄り駅・管理費はあっても駐車場の記載が無いとき、その条件が無いと出力は parking_spaces:1 になります。駐車場のように記載が無い欄も含めて、記載が無ければ null と各欄に書いておくと、同じ紹介文でも parking_spaces は null になります。
解くための考え方
スキーマはどの欄も null を許しているのに、駐車場の記載が無い紹介文で parking_spaces に台数らしい値が入っています。足りないのは null の余地ではなく、記載が無ければ推測せず null を返す、という条件です。その条件をプロンプトに書けば、スキーマを変えずに、作られた値を減らせます。
正確さだけを強調した一文には、記載が無い欄の返し方が書かれていません。欄を必須にして null を禁じると、モデルはスキーマを満たすために値を作る側に寄ります。確信度を併記しても、誤った台数は出力から消えません。
参考資料
問題文:
シナリオ:構造化データ抽出
あなたは、Claudeを使用して構造化データ抽出システムを構築しています。このシステムは、非構造化ドキュメントから情報を抽出し、JavaScript Object Notation(JSON)スキーマを使用して出力を検証し、高い精度を維持します。エッジケースを適切に処理し、下流のシステムと統合する必要があります。
ある企業の経理システムでは、Claude に3つのツールを渡しています。請求書の本文から取引先 ID などを取り出す parse_invoice、取引先 ID で発注データを照合する match_purchase_order、同じ請求の二重登録を調べる check_duplicate です。テストでは、本文に発注番号が書かれた請求書のときに、Claude が parse_invoice を呼ばず、取引先名から推測した ID で match_purchase_order を呼び、誤った発注と照合する例がありました。parse_invoice が確実に最初に実行されるようにする方法として、最も効果的なものはどれですか。
選択肢:
A. match_purchase_order と check_duplicate の説明(description)に、最初に parse_invoice を呼び、その結果の取引先 ID を使って呼ぶツールであることを書き加えます。
B. tool_choice を {"type": "auto", "disable_parallel_tool_use": true} にし、1回の応答で呼ばれるツールが1つまでになるようにします。
C. match_purchase_order の入力スキーマで取引先 ID を required にし、取引先 ID の値がそろうまでは、このツールが呼ばれない状態にします。
D. 最初のリクエストで tool_choice を {"type": "tool", "name": "parse_invoice"} にし、その結果を返した次のリクエストからは、ほかのツールも選べる設定に戻します。
正解:D
A. match_purchase_order と check_duplicate の説明(description)に、最初に parse_invoice を呼び、その結果の取引先 ID を使って呼ぶツールであることを書き加えます。
不正解 ツールの説明は、Claude がツールを選ぶときの判断材料になりますが、呼び出しの順序を強制する仕組みではありません。説明を読んだうえでも、Claude が本文の取引先名から ID を推測して先に呼ぶことは起こり、最初に parse_invoice が実行されることは保証されません。
B. tool_choice を {"type": "auto", "disable_parallel_tool_use": true} にし、1回の応答で呼ばれるツールが1つまでになるようにします。
不正解 disable_parallel_tool_use は、1回の応答で呼ぶツールの数を1つまでにする設定です。どのツールを先に呼ぶかは auto のまま Claude に任されるため、match_purchase_order が最初に選ばれることは防げません。
C. match_purchase_order の入力スキーマで取引先 ID を required にし、取引先 ID の値がそろうまでは、このツールが呼ばれない状態にします。
不正解 required は、呼び出しに含める引数を定めるだけで、ツールを呼ぶ順序は制御しません。今回の誤りは、Claude が推測した ID を引数に入れて呼んだことで起きており、引数を必須にしてもこの呼び出しは防げません。
D. 最初のリクエストで tool_choice を {"type": "tool", "name": "parse_invoice"} にし、その結果を返した次のリクエストからは、ほかのツールも選べる設定に戻します。
正解 tool_choice で特定のツールを指定したリクエストでは、Claude は必ずそのツールを呼びます。最初のリクエストで取引先 ID を含む抽出結果が得られ、その結果を返した後続のリクエストで match_purchase_order などを呼べるため、順序をプログラムで保証できます。
問われている要件
- 依存関係のあるツールのうち、先に必要なツールを確実に最初に呼ばせること
- 後に続くツールも、抽出の結果を使って呼べる状態にすること
前提知識
tool_choice の種類について
-
tool_choiceは、そのリクエストでモデルがツールをどう使うかを指定します。autoは呼ぶかどうかをモデルに任せ、ツールを渡したときの既定です。文章だけを返すこともあります -
anyは、どれかのツールを必ず呼びますが、どのツールを呼ぶかはモデルが選びます -
{"type": "tool", "name": "..."}の指定は、その名前のツールをそのリクエストで必ず呼ばせます。強制が効くのはそのリクエストのターンで、後続のツールは次のターンで処理します -
noneはツールを呼ばせず、文章だけで答えさせます -
disable_parallel_tool_useは、1回の応答で呼ぶツールを1つまでにします。先にどのツールを呼ぶかは、autoのままならモデルが決めます
順序を説明やスキーマで縛る限界について
- ツールの説明は、いつ使うかの判断材料です。説明に、先に別のツールを呼ぶと書いても、呼び出しの順序は強制されず、モデルが推測した引数で後のツールを先に呼ぶことがあります
-
input_schemaのrequiredは、そのツールを呼ぶときに含める引数を定めます。呼ぶ順序は定めません。必須の引数を、前のツールの結果ではなく推測した値で埋めた呼び出しも、スキーマ上は通ります
図による解説
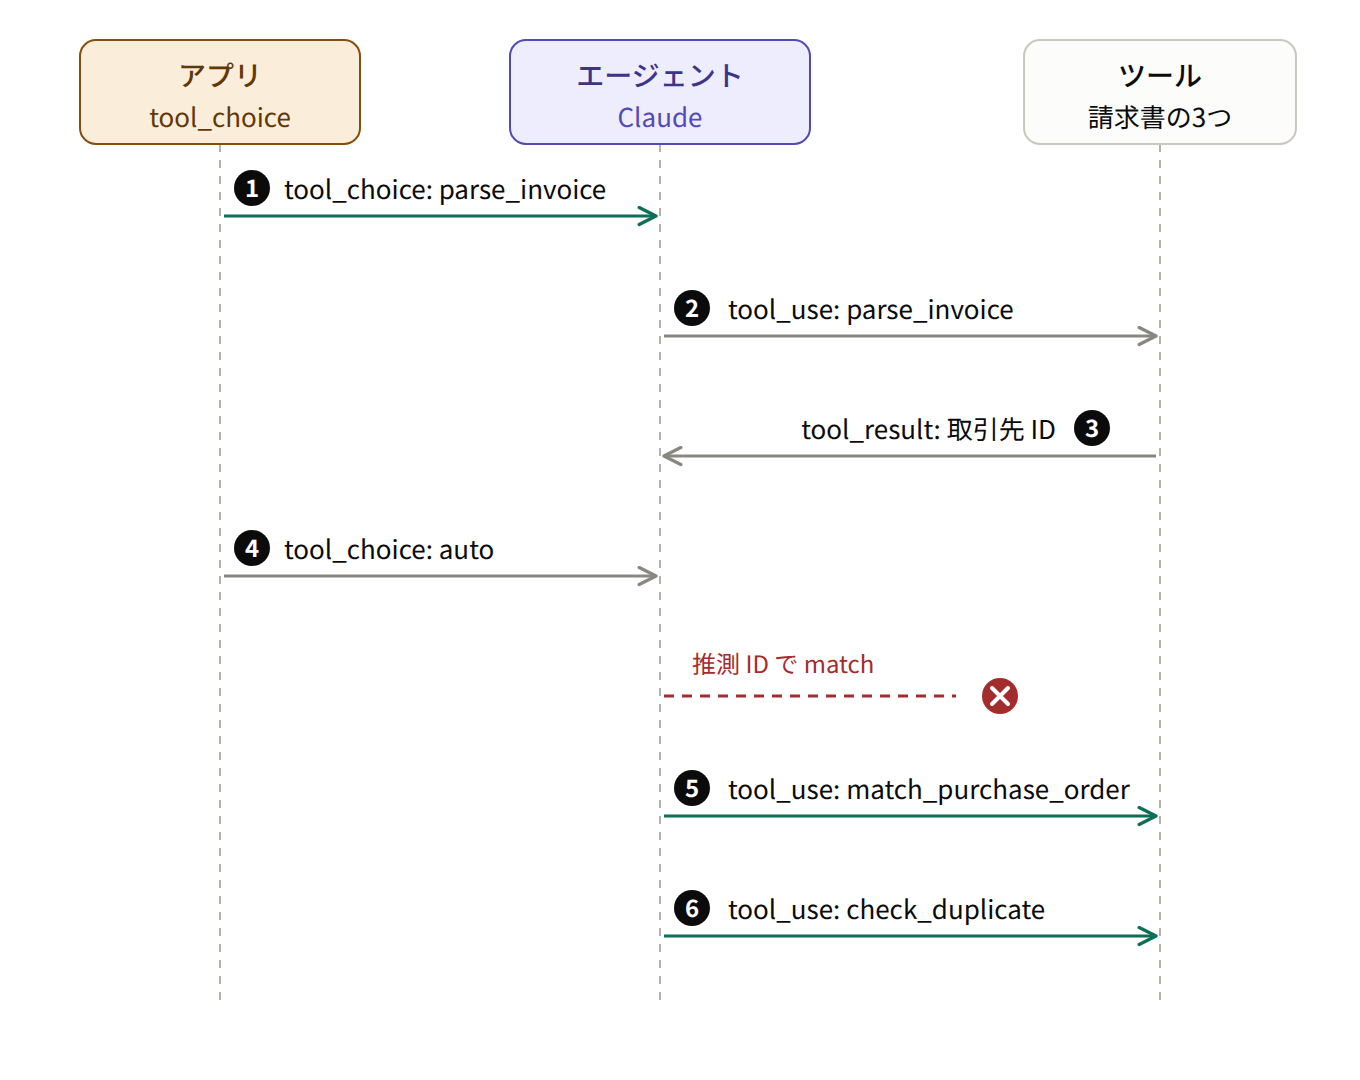
最初のリクエストで parse_invoice を強制し、結果のあと auto に戻します(①〜⑥)。①の tool_choice: parse_invoice により、②で請求書の parse_invoice が先に呼ばれ、③の tool_result で取引先 ID が戻ります。④で tool_choice を auto に戻すと、モデルは戻った ID を使って⑤の match_purchase_order と⑥の check_duplicate を選べます。ID が戻る前に推測した ID で match しても、請求書の取引先とは結びつきません。
解くための考え方
本文に発注番号があるのに parse_invoice が呼ばれず、取引先名から推測した ID で match_purchase_order が先に呼ばれています。後の照合は抽出結果に依存するので、最初のリクエストの tool_choice で parse_invoice を指定し、そのツールを必ず実行させます。結果を返した次のリクエストで auto に戻すと、match_purchase_order と check_duplicate を、戻った ID を使って選べます。
説明に順序を書いても、従うかどうかはモデルの判断のままです。1回の応答で呼ぶ数を1つにしても、最初に選ばれるツールは auto のままなので、照合が先になることを防げません。取引先 ID を required にしても、推測した ID を引数に入れた呼び出しはスキーマを通ります。
参考資料
スポンサーリンク
以下スポンサーリンクです。
この記事がお役に立ちましたら、コーヒー1杯分(300円)の応援をいただけると嬉しいです。いただいた支援は、より良い記事作成のための時間確保や情報収集に活用させていただきます。